字體:小 中 大 |
|
|
|||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| 2026/10/26 14:30:42瀏覽223|回應0|推薦0 | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
擔心 AI 洩漏個案隱私,該怎麼辦? ──給助人工作者與機構的 AI 使用建議及配套措施
王道維/國立清華大學物理系教授 國立清華大學諮商中心主任 國立清華大學人文社會AI應用與發展研究中心副主任
摘要
「AI 會洩漏個案隱私,因此不安全」是許多心理師、社工師、護理師、輔導人員或特教人員等助人工作者面對 AI 時的第一個想法,也往往是人文社會領域——乃至重視創作權益的文藝領域——面對 AI 應用時的主要攔阻點。本文強調在網路與 AI 並存的時代,並不存在絕對而無條件的資訊安全,只有相對且有條件的安全。因此助人工作者在評估使用AI的隱私風險時,應同時評估各種方案的代價與可行性,找出實務工作上更為可行適切的方案。 為此,本文首先釐清常見的混淆:坊間所謂「使用 AI 會洩漏隱私」其實混雜了四類性質不同的風險,真正屬於 AI 模型本身的只有一類,而且最少發生;媒體上常見的外洩事件,幾乎都是平台工程或使用者操作的問題。其次,助人工作者可用的 AI 工具也有四種:個人帳號的商業通用型 AI、機構採購的團體方案,以及分別使用地端與雲端模型的助人專用型 AI,各自的保護程度與代價不同。本文認為,對於帶有敏感個資的紀錄,使用雲端模型、可搭配地端模型的助人專用型 AI 是較務實的選擇:它以機構名義透過 API 呼叫模型,服務商難以辨識是誰輸入、也難以串聯不同時間的對話,這是個人帳號做不到的;機構的團體方案則適合承擔一般行政,兩者並不互斥。 在此基礎上,本文建議助人工作者先分辨手上的資料是否帶有個案的敏感資訊。若沒有,以個人或機構帳號的通用型 AI 加速行政即可;若有,則只需做到兩件事:使用有安全設計的助人專用型 AI,以及送出前刪除可辨識個案的資訊。後者看似直觀,但資安管理不能只靠個人自律,更要靠系統設計來承擔。因此機構與政府也應推動助人專用型 AI 的分級標準;本文提出三級參考標準與一個混合雲端與地端模型的實例,並附上兩份簡易檢核表,分別供機構檢視系統防護、供助人工作者使用前自我提醒。簡而言之,資安固然重要,但它應建立在務實可行的系統設計與使用規範上,而非無限上綱,才能讓助人工作者放心使用,創造社會的最大效益。 本文有個簡短的影片介紹,也歡迎參考,請點選(連結)。
本文大綱
一、前提:網路時代沒有絕對的資訊安全 二、釐清混淆:四類風險 三、比較對照:四種AI工具的應用方式 四、個人能做的第一件事:選擇有安全設計的助人專用型 AI 五、個人能做的第二件事:刪除可辨識個案的資訊 六、機構與政府的責任:推動助人專用型 AI 的分級標準 七、結論:讓資安成為使用的條件,而非拒絕的理由 附錄一:助人專用型 AI 隱私保護檢核表 附錄二:助人工作者使用 AI 的自我檢核表 一、前提:網路時代沒有絕對的資訊安全
大型語言模型(Large Language Model, LLM)普及至今不過數年,影響所及,幾乎所有行業都受到正面與負面的衝擊。從正面來說,許多大型AI科技公司所開發的「商業通用型AI」,如國人較為熟知的OpenAI的 ChatGPT、Google的Gemini與Anthropic的Claude,的確能力越來越強,已經可以應用於許多辦公場景,加速行政庶務的處理,提升專業工作的效率。只可惜對於平常已經被大量行政文書壓得喘不過氣的助人工作者而言[1],卻還需要多考慮一個重要的隱私保護問題:「把個案的內容輸入 AI真的安全嗎?AI會不會偷走個案的資訊?」但由於對 AI 技術的內涵不夠熟悉,實務現場往往是:官方高層聲明一切從嚴,言之鑿鑿,但是基層工作者卻常常因為庶務的重擔,只能私下以個人帳號購買商業AI來協助其工作。這樣的狀態在未來應該要有更好的解決方式。
在回答這個AI與隱私安全的問題前,本文認為我們必須先承認一個前提:在網路存在的今天,其實並不存在絕對而無條件的資訊安全,只有相對性且有條件的安全。舉例來說,生活中的電子郵件可能誤寄或遭入侵,雲端檔案可能因權限設定錯誤而公開,通訊軟體的訊息可能被截圖轉傳,機構的紀錄系統也可能因軟體漏洞而外洩。如果要求絕對的資料安全應該要完全斷網處理資料,但是那需要付上資訊傳遞延遲或決策緩慢的代價,否則就應該要有更為昂貴的設備與通訊器材。因此,資訊安全是需要用資源與實務的便利性為代價來換取的,也因此對於我們一般人而言,其實早已在「有限資源所建造的相對安全環境」中工作與生活。而對於服務一般社會大眾,甚至底層弱勢族群的助人工作者,自然更不太可能脫離這樣的環境來執行其專業服務。因此,如何能在有限的資源與相對的資訊安全中,創造對個案與助人工作最大的價值,才是我們應該思考的方向。
但因為 AI 科技發展過快,非相關領域的人難以完全了解,人文社會領域(包括助人工作者與文藝創作者)面對 AI 應用時,自然對資料風險有更高的疑慮。這份審慎值得尊重,但若停留在一味的拒絕而缺乏對風險層次的辨識,便既無法安心使用,也說不清究竟在防範什麼。而這樣的拒絕還可能為助人工作帶來一個不易察覺的犧牲:讓本來能夠協助促進服務效能的 AI 應用因為這樣的疑慮被排除,反而違背了助人工作成就社會共善的原始初衷。這一點即使從專業倫理的角度來看也是如此(見第七節)。換言之,這並不只是「這一次輸入安不安全」的個人性問題,更是一個專業領域如何與 AI 建立可用關係的集體性問題。
以下先從AI相關的技術層面釐清幾種常見的混淆,再分別說明助人工作者個人能做的事,以及機構與系統設計者應負的責任。本文所說的助人工作者,泛指心理師、社工師、護理師、輔導與特教人員等在工作中會接觸他人私密處境的專業;以下以筆者較熟悉的心理師與社工師為例,其原理可類推到其他領域。
二、釐清混淆:四類風險
助人工作者常擔憂的「AI 會洩漏個案隱私,因此不安全」,其實可能混雜了性質完全不同的四類風險(見表一)。我們應該要先區別這些類型,才能把問題的範圍定義清楚,減少不必要的聯想或猜測。以下僅作簡要說明,技術細節不多展開。
第一類是關於AI公司的資料處理方式:對於我們所熟知的AI科技公司(如OpenAI, Google, Anthropic等)來說,消費者版的對話的確有可能被用於AI模型訓練,而研究也證實,模型在特殊的誘導下,也的確可能吐出訓練時所記憶的片段[2],理論上便可能讓個案的隱私被他人知道。但這類風險的前提,是資料先被納入訓練,而這一步是使用者可以把關的,並非「AI 會主動竊取個案資料」。事實上,「模型本身洩漏」的真實案例極少,已知的例子幾乎都來自研究者刻意設計的實驗;而即使在這類實驗中,能被逐字吐出的也多半是網路上重複出現多次的內容,一般人只出現一次的敘事,很少能被原樣重現[3]。
第二類與語言模型無關,只是剛好發生在 AI 產品上。例如2023 年,ChatGPT 曾因快取程式庫的錯誤,短暫讓部分使用者看到他人的對話標題[4];同年,三星電子因員工將內部程式碼貼上 ChatGPT 而限制員工使用生成式 AI[5]。前者是後端工程漏洞,任何網站都可能發生;後者是貼了本來就不該貼的東西,即使用電子郵件寄出也一樣有問題。這類經由 AI 服務發生的外洩,案例的確不少:2025 年初,DeepSeek 曾因資料庫未設密碼,使超過一百萬筆紀錄(包括對話內容)可被公開存取[6];同年,ChatGPT 的使用者在分享對話時勾選了「可被搜尋」,以致上千段對話可以從搜尋引擎查到[7]。但這些幾乎都是平台設定錯誤或使用者操作造成的,與 AI 模型本身無關。
第三類是因為商業信任、地緣政治與輿論渲染,例如 2025 年 DeepSeek 引發的禁用爭議[8]:資料落地於哪個司法管轄確實應個別評估,但這更接近政治信任或產品認同的問題,而非使用 AI 本身的問題;它也最容易因地緣政治與商業競爭而被激化。對大多數助人工作者而言,只要依循所屬機關的規範(例如公部門已禁用特定產品[9]),便不必為此另外擔心。
最後第四類是AI 被當作攻擊工具,例如深偽詐騙或以 AI 對網路照片進行大規模的人臉再識別[10]。與此類似的,還有能自行上網執行任務的 AI 代理人(AI Agent)在研發測試中越界,逃脫 AI 公司所設計的封閉測試環境,往外入侵其他網站的系統[11]。這類風險屬於 AI 被誤用或尚未被有效掌握,並不是「輸入個案資料導致外洩」,卻最容易經由新聞報導引發對 AI 的恐慌,與實際的助人工作沒有直接關係。
由以上的分析可知,真正屬於 AI 本身、需要讀者自行評估的隱私風險,其實只有第一類;第二類雖然確實會發生,卻屬於系統工程與使用習慣的問題,這也正是後文所說的專用型 AI 可以替使用者把關的部分。但是我們在新聞媒體上所看到的或被渲染的事件,卻幾乎都是後三者(第一類反而極少),也因此造成許多人對於AI隱私風險的不對稱評估和莫須有的猜忌,影響AI在助人工作領域的發展機會。
表一:四類「AI 洩漏隱私」風險對照
(作者整理)
三、比較對照:四種AI工具的應用方式
除了以上四類風險,另一個常見的混淆,是把不同的使用層級或系統架構混為一談。更具體來說,我們應該要區分個人消費者使用商業通用型AI的安全性,與機構採購的團體商業方案。而透過應用程式介面(Application Programming Interface, API) 串接的專用型AI,也可以源自於機構內的地端模型,或是位於異地資料中心的雲端模型。這些不同的AI工具選擇在安全性、實用性與經費負擔上也都有不同的代價。一個有效的AI工具評估,應該要全盤考慮實際的工作需求與所能夠付出的合理時間與經費代價。因此,對專業工作者而言,選擇哪一種合適自己的AI系統方案,遠比「用不用 AI」更為關鍵。以下依序說明四種工具類型。
首先是我們一般人最熟悉的「使用個人性商業通用型AI」,包括國人最熟悉的三家美國科技公司:OpenAI的ChatGPT,Google 的Gemini 與Anthropic 的Claude,或者其他中國公司的產品。其隱私設定因各家公司以及免費、付費版本而有差異,但共同點是:對話內容可能被用於 AI 訓練,除非使用者在設定中主動關閉(多數公司的免費版與付費版都提供這個選項,但預設值不一)[12]。但即使關閉了訓練,對話紀錄仍保存在個人帳號中,仍可能因為分享連結而被公開[7]、因為共用電腦未登出而被他人看見,或因為儲存大量個人化的記憶而被串連認出;換言之,關閉訓練只擋住了其中一條路。這也是本文不建議助人工作者以個人帳號的商業通用型AI處理個案資料的原因;但如果沒有更好的替代選項,也實在不能責怪這些已經在助人現場盡力付出,卻仍須負擔吃重行政文書工作的助人工作者。
其次是「使用機構購買的企業團體通用型AI」,例如有些大公司或學校購買微軟(Microsoft)、Google或亞馬遜(AWS)的企業方案,依合約保證資料不用於 AI 訓練,部分方案也可約定資料存放的地區(例如境內的資料中心)。此方式的確可以進一步免除個人使用者因為自己的誤用而將資料外洩的可能。但是這類團體方案需要依人數長期付費:以 2026 年常見的報價而言,每人每月約 20 至 30 美元(約新台幣 650 至 1,000 元),若是加購於既有的辦公軟體授權之上,總價還會更高[13]。若以一般企業價格估算,一個 50 人的機構一年約需新台幣 40 萬至 60 萬元;但是目前非營利組織可透過科技濃湯(TechSoup Taiwan)等管道申請各公司的非營利優惠方案。這類方案雖然仍綁定個人帳號、保存對話紀錄,但比起個人帳號,已經多了機構的帳號管理與合約保障,適合承擔一般性的行政工作。此外,此方案所得到的幾乎只有使用不同 AI 模型的權限,並不等於能夠有效的優化成為適合助人工作者的工具。表二並列出第三、四種工具共同採用的 API 串接方式,以便對照。
表二:三種使用方式的隱私處理差異(以 Anthropic 為例)
(作者整理;Anthropic政策以官方最新公告為準,細節見附註[12])
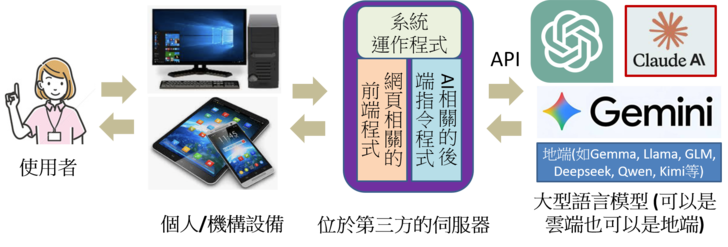
第三與第四兩者都是關於「助人專用型AI」,差別只是在於所使用的大型語言模型是來自於雲端還是地端。綜合而言,本文所謂專用型 AI 系統,是介於使用者與大型語言模型(LLM)之間,透過終端設備(如筆電或手機)以及應用程式介面(API)來連結兩者,是依專業需求而特別設計開發的第三方中介系統(見圖一)。從技術面來看,這個專用型AI的核心主要是一個複雜的駕馭工程(Harness Engineering):透過精心設計的網頁介面,使用者看不到的系統指令(system prompt),以及種種流程設計或反饋檢測,可以做到偵測、加工、調整或攔阻雙方互相傳遞的訊息,以達成某些專用功能(例如社工的紀錄撰寫或心理諮商的個案概念化)的最大優化。使用者不必自行撰寫提示詞,就能讓專業能力與 AI 更好地結合。這個第三方的系統當然也可以因應隱私或法律的需求,同時檢驗使用者上傳到LLM的資料是否符合規範,降低個人疏失所造成資料外洩的問題。此外,由於服務商端看到的請求都來自這個系統的伺服器,而非個別使用者的帳號,也就難以辨識是誰輸入,更難把不同時間的對話串連成某一個人或某一個個案的完整紀錄。
圖一:專用型AI的架構(作者自製)
事實上,這類的情形其實早已在其他領域,例如金融、法律、科技、商業、醫療、工程等快速發展,只是在助人工作領域卻相對落後許多,以至於大多數助人工作者所理解的AI工具,幾乎都是通用型AI(也就是聊天機器人),只能使用最常見的指令來協助助人工作中最表淺的部分,也因此實際的幫助有限。這是筆者一直覺得非常可惜的事情。筆者期待,如果未來能有更多助人工作者將其專業與AI相結合,應該可以讓助人專用型AI在功能上更百花齊放,有更多不同的發展與應用來滿足不同類型專業工作者的需求。 但是第三與第四種工具的差別,主要不在前端的設計,而是後端的基礎模型。兩者的比較可見於表三。一般常有的說法是,認為最好的隱私保護是機構使用地端模型,讓使用者只能在機構使用AI,以至於資料不出機構。雖然從資料流動的角度來說,這個說法可能是正確的,但是我們不能忘記,使用AI的主要理由本來是因為可以在經費可負擔的範圍內來提升工作效率,減輕行政負擔。(如果把隱私放到唯一最大需求,那根本就不應該使用AI。) 如果要部署地端的AI模型,有兩個必須考慮的限制:首先是那往往需要動輒百萬元以上的算力與設備投入,加上長期維護的系統人員,才能讓地端的設備穩定運作,並且得以運行足夠大的AI模型[14]。因此要部署地端模型並非個人或中小型機構所能負擔的成本。
此外,以目前國際AI模型的發展來看,以美國為首的閉源模型雖然仍有相當領先的優勢,但是以中國為主的開源模型(如DeepSeek, GLM, Kimi或Qwen)也已經在效能上緊追,並且以便宜得多的價格獲得更多國家的考慮。但是台灣基於資安與國情的考量,規定公務機關不得使用中國廠牌的 AI 服務(包括下載到地端使用),受政府委託、須交付書面成果的採購案也有類似的限制[9];民間機構雖未被禁止,也多半有所顧慮。因此台灣的社福機構若要自行部署開源模型,往往只能選擇效能較弱的非中國模型。但是助人工作者其核心的資料往往都是相當大量且複雜的訪視紀錄或諮商紀錄,以目前單一主機可負擔的非中國開源模型而言,要有效處理這類長篇而複雜的紀錄,仍有明顯的限制。即便國科會曾經有TAIDE計畫想要用台灣獨有的資料來微調一些美國開源模型,但是受限於資料的類型與數量不足,以及訓練經費的限制,在長篇專業紀錄的分析上,目前也仍難以取代前沿的閉源模型。
表三:雲端(閉源)模型與地端(開源)模型的差異
(作者整理)
綜合表二與表三可知,四種工具各有其代價:個人帳號取得最容易,卻最依賴使用者自己的節制;機構團隊方案以合約解決了訓練與保存的問題,卻須依人數長期付費,也不會因此變得更貼近助人專業;地端模型讓資料不出機構,卻需要可觀的設備與人力,能力也受到限制;雲端模型的專用型 AI,則能在可負擔的成本下,同時取得前沿模型的能力與系統性的隱私把關,必要時再以地端模型處理去識別化等前置工作(後文將提出一個實例)。因此,本文認為對於帶有敏感個資的紀錄,第四種方式應是目前最務實可行的選擇。但這並不表示機構方案與專用型系統必須二擇一:前者可以承擔一般行政,後者處理敏感的個案紀錄;機構的雲端企業帳號,甚至也可以直接作為專用型系統呼叫模型的 API 後端,只是相關的收費方式或建置成本就要另行考量。
四、個人能做的第一件事:選擇有安全設計的助人專用型 AI
釐清了這些混淆之後,問題便可以收斂下來,討論助人工作者個人可以如何安全有效地善用AI工具。不過在此之前,還有一個預備的步驟:先分辨手上要處理的資料,是否帶有個案的敏感資訊,例如訪視錄音與逐字稿、訪視或諮商紀錄,以及填有個案資料的各類表格。若沒有,例如一般公文、活動企劃、會議紀錄或對外的宣導文字,即使以個人帳號的商業通用型 AI 來加速行政工作,其風險也與平日使用電子郵件或雲端文件相去不遠,不必過度擔心;若機構已有團體方案,則更宜優先使用。
本文以下的建議,針對的是前一類帶有敏感個資的資料,而非所有的工作內容。對於這類資料,助人工作者個人真正能做、也需要做的,其實只有兩件事:其一,儘量使用有安全設計的助人專用型 AI,而不要透過個人帳號使用商業通用型AI來作高敏感資料處理;其二,送出前刪除可明確辨識個案的資訊。這兩件事是可以互補以增加隱私保護的可靠度:前者決定資料流經什麼樣的環境,由系統的設計來防範人為管理可能出現的疏忽(其實大部分的隱私風險都屬於此類,見表一);後者則是決定資料本身是否還帶著身分,即使萬一系統出了狀況也仍然不會全部失守。若能同時做到這兩件事,助人工作者應可以放心使用AI工具,不必再過度擔心資安問題。以下先就第一點做更詳細的說明。
由於專用型AI系統是介於使用者與大型語言模型之間(見圖一),因此主要可以有以下三種方式來強化個案的隱私保護:其一是架構上的攔阻:例如可以設定為無須個人帳號、不保存對話、不提供記憶與分享功能,許多原本會綁定在特定使用者身上的個案資訊便不復存在;其二是介面上的提醒,在使用者輸入時主動提醒以化名與概括化方式描述個案,減少被辨認的風險;其三是可以在資料送出之前,先行偵測人名、校名、系級、地名與日期等使用者可能無意間輸入的個資,自動替換為較為通用的代號——由於這一步在使用者的裝置或機構內部完成,並不會多出一個外部經手資料的環節。以此對照個人帳號的商業通用型 AI,差異便相當清楚(見表二)。
從實務來看,執業現場最可能發生的外洩,往往不在 AI 公司端,而在使用者這一端:共用電腦未登出、瀏覽器保留對話紀錄、手機通知在會談室跳出、分享連結被轉傳,或消費者版的「記憶」功能跨對話保存了個案資訊。這些都與模型無關,卻比任何模型風險更貼近日常,而專用型 AI 的前端設計正可以把這些環節管住。
另一種較少被注意的保護,則發生在服務商端。如果使用專用型的AI,即便後端是接到外部的AI公司,但是由於所有使用請求都來自同一個系統伺服器、共用同一個機構帳號,個別使用者便混入整體流量之中:服務商即使看得到某段對話,也難以得知是誰輸入,更難以把不同時間的對話歸屬到同一位使用者或同一個個案。但是綁定個人帳號的商業通用型AI系統恰好相反——所有對話都來自於同一個帳號之下,長期累積,再加上記憶功能,便逐漸形成一份可追溯到個人的完整紀錄。換言之,API 加上中介層,可以結構性地避免「身分的辨識」與「跨時間的串聯」,但是單次對話的內容仍要靠去識別化來完成,而這部分亦可藉由專用系統以地端模型自動判讀並替換個資,降低疏漏的可能。
由此可見,專用型系統的價值,並不在於用了什麼更神秘的技術,而在於它把最容易出錯的環節,從倚賴使用者的好習慣轉移到系統的架構設計來承擔。這並不表示專用型系統可以免除一切注意:去識別化仍是使用者的責任,地端部署的安全也有賴機構的管理,但是在同樣做好去識別化的前提下,使用專用型系統的整體風險,應可明顯低於在個人帳號上直接輸入。
五、個人能做的第二件事:刪除可辨識個案的資訊
首先,筆者希望澄清一個助人工作者常有的誤解:個案的資訊對當事人而言極為重要,不希望被不認識的他人得知,而這也正是保密義務存在的理由。但是從隱私保護的角度來看,「對當事人重要」並不代表對其他刻意來破壞資安,擷取大量資訊的網路攻擊者有價值。畢竟網路攻擊往往需要成本,攻擊者自然會把資源投向回報最高的目標,例如國家機密、銀行帳戶、支付憑證、或是政要名人的私生活等等。相較之下,一段青少年的諮商輔導紀錄幾乎無法變現,也缺乏特殊性 (以AI公司每天千萬名使用者的大數據資料來說,類似的經歷很可能也出現在其他人的使用紀錄中,或至少在許許多多的小說電影故事裡)。因此,在每天流動的巨量資訊中,特別是當移除可辨識的姓名、電話或身分證資訊後,就像一個無主的八卦流言,即使洩漏也如同沉入資訊大海的雜訊,無從拼湊出完整的圖像,不可能再被對應到特定的人。這就如同遺失了一把鑰匙,只要個案資料中的「門牌」被有效移除,即使有人從鑰匙堆中撿到也無法得知它能開哪一扇門,也就失去這個鑰匙的功能。
即使退一萬步,個案資訊真的被送入模型訓練,也很難維持原貌被認出:語言模型學的是字詞與概念之間的統計關聯,而非整段背誦。一段敘事進入訓練後,會與無數相似的文字交織在一起;日後即使被誘導「說出」,產出的也多半是拼接、變形甚至虛構的組合——這正是俗稱的「AI 幻覺」。能被逐字背出的,多半是重複出現或字串極為獨特的資料(例如密碼);而失戀、家庭衝突、疾病歷史這類敘事,是無數人共有的人生故事,再被完整對應吐出的可能性極低。就這一點而言,坊間的擔心確實被誇大了。
不過這裡所說的「門牌」,並不只是姓名、身分證字號或電話這類直接識別的資訊。系所年級、家庭結構、罕見的事件或特定的時間地點,單獨看來都不足以指認任何人,組合起來卻可能讓熟悉這個場域的人一眼認出當事人——這類資訊可稱為「準識別資訊」。因此比較實用的判斷方式,是想像一位熟悉這個場域的同事讀了這段文字,是否仍然認不出是誰(附錄二第 5 題)。若認得出來,就應再概括化一次,例如把「某校社工系大三、父母剛離異的獨生女」改為「一位大學生,家中近期遭逢變故」。做到這一步,前面所說的「鑰匙」便不再對應任何一扇門。
但是也許唯一需要特別看待的,是公眾人物與曾受媒體大量報導的個案。網路、政治或影視名人的私人故事,經由商業傳播早已為許多陌生人所知,曾登上新聞的事件也是如此;原本只是陌生人的故事,也因此可能讓人認出當事人。服務這類個案的助人工作者,確實應更為謹慎,甚至避免使用AI。但這畢竟是極少數的例外,對於多數服務一般民眾、當事人不具公眾知名度的助人工作者而言,這層擔憂大多可以放下。
以可否識別作為判斷的思路與我國法規的邏輯也恰好一致。《個人資料保護法》所稱個人資料,涵蓋「得以直接或間接方式識別該個人之資料」[15];法律在意的,正是間接識別的可能。反過來說,經充分處理而無從識別特定個人的資料,便不再落入個人資料的範疇。至於心理師、社工師依其專業法規所負的保密義務[16],其核心在於不得無故洩漏因業務而知悉的他人秘密;當輸入的內容已無從指認當事人,爭點便可能從「是否洩漏特定當事人的秘密」,轉向「專業判斷如何在工具輔助下進行」。惟此一轉換是否成立,仍取決於去識別化是否確實到位。筆者並非法律專業,此處僅指出技術事實與法規邏輯的交會點,具體的適用與解釋,仍有待法律與助人專業社群進一步討論。
六、機構與政府的責任:推動助人專用型 AI 的分級標準
前兩件事是助人工作者個人所能做的;但手上的工具是否具備安全設計,個人往往無從選擇,這便是機構或政府的責任。在提出本文的標準之前,必須先說明既有的政府規範已經做到了什麼,以及還留下了什麼。
6.1 既有規範與本文的位置
政府在這方面其實已有不少規範。早在民國 112 年(2023),行政院便訂定〈行政院及所屬機關(構)使用生成式AI參考指引〉,要求公務人員不得向生成式 AI 提供涉及公務應保密、個人及未經同意公開的資訊,但封閉式地端部署的模型,得於確認系統環境安全後依機密等級分級使用[17]。民國 115 年(2026)施行的《人工智慧基本法》,進一步要求各級政府機關完成公務使用 AI 的風險評估並訂定內控規範,數位發展部也已公布〈人工智慧風險分類框架〉[18]。《個人資料保護法》的修正條文也已於 2025 年 11 月公布,將設立個人資料保護委員會作為統一的監督機關[15]。在專業領域方面,衛生福利部訂有〈醫療機構應用生成式人工智慧指引〉[19],教育部則訂有〈高級中等以下學校人工智慧使用和學習指引〉,明文要求教師避免上傳學生的姓名、學號、聯絡方式與家庭背景[20];國內心理學界也已有學者主張,研究倫理審查應就敏感訪談資料交由商業平台處理訂定去識別化準則[21]。相較之下,社會福利與諮商實務領域,目前仍缺少專門的指引。
這些規範的方向與本文大致一致,但多半有兩個共同的特點。其一,是以「不得提供個人資訊」為主軸。這固然正確,卻沒有說明什麼才算可識別——拿掉姓名之後,系所年級、家庭結構與罕見事件的組合是否仍屬個人資訊(見第五節);也較少處理共用電腦未登出、對話紀錄外露這類使用端的疏失(見第四節)。其二,是以「是否為地端模型」作為主要的分界,彷彿只要資料不出機構就是安全,出了機構就不安全。然而工具的安全,其實取決於兩個不同的向度:介面是通用還是專用,模型是在地端還是透過商業 API。兩者交叉之後,便有四種組合;而後兩者其實還可以混合運用產生第五種,各有其優點與限制(見表四)。
表四:AI 工具的兩個向度與常見配置
(作者整理)
由表五與前文可知,地端模型並不必然是最好的選擇。它的確讓資料不離開機構,但開源模型的能力多遜於前沿模型,處理長篇個案紀錄或較複雜的分析時,往往力有未逮;建置與維運需要硬體、經費與專業人力,多數社福機構與小型諮商所並無這樣的資源;而它的安全也全然仰賴機構自身的管理,一個缺乏更新與權限控管的地端伺服器,其風險未必低於一個有合約約束的商業服務。 因此,本文對於助人專用型AI所提出的理想標準,比較接近表四的第五種,與既有的隱私規範有兩點不同:在使用者端對此專用型AI要求得更嚴謹,而在其部署方式上則更要求有彈性,可以混合地端與雲端模型。前者是指不只禁止輸入個人資訊,還建議系統除非必要,不綁定使用者身分、不保存紀錄、主動提醒去識別化,並以內建的地端模型協助主動去識別化的標準;後者則是不以地端與否作為唯一的分界,而以資料最終是否在外部留存、留存多久、由誰保證,來決定可以處理什麼樣的內容。這並不是要取代既有的規範——在公部門服務的工作者,仍應以所屬機關的規定為準——而是希望在規範尚未觸及的地方,提供一個更細緻也更可行的參考。
6.2 三級參考標準
以下依使用情境的敏感度,提出三個層級的參考標準(見表五),並於附錄一提供可逐項核對的檢核表。這三個層級針對的是帶有敏感個資的資料處理;不含個案資料的一般行政工作,如第四節所述,使用個人或機構的通用型 AI 即可,不必套用這些標準。必須說明的是,這是標準與方向,而非任何現有系統——包括筆者團隊所開發者——都已完全達到的水準(見附註[22])。
表五:助人專用型 AI 系統的分級參考標準
(作者整理)
這三個層級並非平行的選項,而是逐級疊加:基本級處理的是「不讓資料擴散」,進階級處理的是「攔阻使用者的意外」,高敏感級處理的則是「讓資料不在外部留存」——無論是採地端模型,或是簽署零資料保留協議的商業 API。機構可依自身業務的敏感度決定所需的層級,設計者可據以規劃功能的優先順序,使用者則能據以判斷手上的工具適合處理什麼樣的內容。
6.3 從標準到實作:一個混合配置的例子
標準若要可行,還需要落到具體的配置上。地端模型與商業 API 其實並非二選一。以筆者團隊目前已經實作並開放使用的「AI社工紀錄輔助系統」為例[22]:在地端達到前沿商業模型的分析能力,需要數百萬到上千萬元的硬體;透過 API 生成一次紀錄初稿,成本不過新台幣兩、三元[14]。因此較務實的做法,是依工作的性質與資料的敏感度分流:規則明確或不宜出境的工作(例如訪視錄音轉逐字稿與自動去識別化)放在境內或校內處理,需要整合判斷的紀錄撰寫與處遇分析,才在去識別化之後送往外部的商業模型(見表六)。但是這只是為了減少個資外流的風險,並不能取代使用者(社工)仍儘量先自行去識別化後再上傳的責任。
表六:依工作性質與資料敏感度分流的配置:以 AI 社工紀錄輔助系統為例
(作者整理;自動去識別化功能部署中)
這樣的分流,再搭配幾項簡單的設計,便能讓隱私的考量成為可以執行的流程:系統無須登入,工作內容只暫存在使用者自己的瀏覽器分頁中,伺服器也不記錄請求的內容;送往雲端之前,由地端模型自動替換可識別資訊,而不只靠使用者自己記得;未來也宜讓使用者在送出前預覽實際要送出的文字,確認後才送出。
七、結論:讓資安成為使用的條件,而非拒絕的理由
回到最初許多助人工作者的疑慮,「AI 會洩漏個案隱私,因此不安全」,我們就會發現正確的答案不是「安全」或「不安全」二選一,而是:沒有絕對的安全,只有相稱的條件——對個人而言,是選擇有安全設計的專用型 AI,並且不輸入可辨識個案的資訊;對機構而言,則是為一般行政提供機構層級的帳號,為敏感紀錄提供符合標準的專用型工具——後者以機構名義呼叫模型,服務商難以辨識個別使用者,這是個人帳號做不到的。但是我們也需要了解,這兩個做法並不對稱:個人的去識別化隨時可以做到,機構的工具卻需要時間與資源建置;但後者正是讓前者不必全靠個人紀律的條件。資安焦慮若停留在「用或不用 AI」的二選一,便只會在兩個極端間擺盪:或因恐懼而全面拒絕,或因方便而毫無防備。
但筆者更想提醒,助人工作者如果因為一些說不清楚或被媒體混淆的因素而完全拒絕使用AI,將可能讓未來的專業人員失去成長的機會,將熱情消耗於明顯落後於其他行業的庶務工作。這其實也與助人專業本身的倫理要求並不一致:以社工為例,美國社工協會的倫理守則便明文要求,以科技提供服務者應具備勝任的知識與技能;在社工倫理決策常用的原則排序中,隱私保密也排在最小傷害與生活品質之後[23]。可見保密雖然重要,卻並非凌駕一切的原則;只因保密的顧慮便放棄可能增進服務對象福祉的工具,未必是審慎的專業判斷。但反過來說,排序在後也不等於可以放鬆:以 AI 撰寫或生成紀錄初稿時,社工基於責信,仍須在有限的條件下保障個案隱私,而不主動揭露、或先屏蔽可識別資料,正是最基本的要求。這也是本文把去識別化與自我檢核(附錄二)視為使用者責任、而不只是建議的原因。此外,社福機構即使願意引入AI,採購時也往往傾向信賴大型品牌的商用AI權限,而較少思考如何結合其服務專業與學界或非營利單位合作開發助人專用型AI,恐怕也很難將AI的功能落地於真實在地的需求。
從「AI公共化」[24]的角度來看,AI與助人工作者合作的出路不是只是開放使用商業通用型AI,而是要讓助人工作者參與開發助人專用型 AI,並且在開發、測試、使用、驗收與回饋的過程中培養辨識風險與善用工具的能力[25];本文整理的條件與標準,正是讓資料在保護隱私的前提下服務公眾的機制。資安當然重要,但它應該是讓我們得以放心使用的條件,而不是讓我們放棄參與的理由。唯有當專業社群普遍具備這種分層判斷的能力,以公共利益為念的 AI 才可能真正落地。但是當然,本文所述也都受限於筆者有限的觀察角度,僅在拋磚引玉,期待助人專業、法律與資訊領域的社群,共同發展出更細緻的助人專用型 AI 工具,以及有效可行的判斷標準。
附錄一:助人專用型 AI 隱私保護檢核表(供政府單位、機構與系統設計者參考)
以下檢核表依第六節的三個層級編排,供機構採購、系統設計與使用者自我檢視之用。判讀方式是逐級疊加:A 類全數符合者為「基本級」,可用於已充分去識別化的個案討論;A、B 兩類全數符合者為「進階級」,可用於常態性的個案討論與紀錄撰寫;三類全數符合者為「高敏感級」,方適合處理逐字稿、危機、未成年或涉及司法程序的內容。若 A 類有任一項未符合,則其隱私保護宜視同個人聊天機器人,僅用於不含個案資料的用途。
表七:助人專用型 AI 隱私保護檢核表
(作者整理)
需要說明的是,這份檢核表是自我檢視的參考,而非認證;它的用意在於讓不同的系統能放在同一把尺上比較,而不是替特定系統背書。其中多數項目,使用者只要查閱系統的隱私說明或實際操作一次即可確認;需要詢問開發單位的項目,則正是機構在採購時應當要求對方說明的部分。
附錄二:助人工作者使用 AI 的自我檢核表
附錄一檢視的是工具,本表檢視的則是使用者自己。它對應本文所說個人能做的兩件事,依使用的先後分為三組:使用前確認工具,送出前確認內容,使用後確認責任。前五題是基本條件,皆能答「是」時,一般的個案討論便可以放心進行;第六、七題用以辨認少數需要更多條件的情形;後兩題則屬專業責任,與工具是否安全無關,卻同樣不可省略。
表八:助人工作者使用 AI 的自我檢核表
(作者整理)
附註
[1] 林琮恩(2026/4/2),〈調查8成社工過勞 最缺制度支持〉,聯合報。報導引述「台灣社會工作職業安全心理衛生調查」:近八成社工有中度以上的過勞,「制度支持」是工作環境各面向中得分最低者。https://udn.com/news/story/7266/9417598 [2] Nasr, M., Carlini, N. 等(2023),Scalable Extraction of Training Data from (Production) Language Models,arXiv:2311.17035。https://arxiv.org/abs/2311.17035 [3] Manne, G. A. 等(2026),AI Memorization,International Center for Law & Economics。該文整理相關研究指出,可回復訓練原文的輸出約占 0.03% 至 1.4%,且多為網路上重複出現的內容,目前並無一般人個資自正式營運模型中被萃取的真實案例;作者立場傾向限縮對模型的管制,引用時宜持保留。https://laweconcenter.org/wp-content/uploads/2026/02/AI-Memorization-v5.pdf [4] OpenAI(2023/3/24),〈March 20 ChatGPT outage: Heres what happened〉。https://openai.com/index/march-20-chatgpt-outage/ [5] Gurman, M.(2023/5/2),〈Samsung Bans ChatGPT, Google Bard, Other Generative AI Use by Staff After Leak〉,Bloomberg。https://www.bloomberg.com/news/articles/2023-05-02/samsung-bans-chatgpt-and-other-generative-ai-use-by-staff-after-leak。中文報導見林妍溱(2023/4/7),〈員工外洩內部機密!三星開放ChatGPT後出事緊急限縮使用〉,iThome。https://www.ithome.com.tw/news/156291 [6] Wiz Research(2025/1/29),〈Wiz Research Uncovers Exposed DeepSeek Database Leaking Sensitive Information, Including Chat History〉。https://www.wiz.io/blog/wiz-research-uncovers-exposed-deepseek-database-leak。中文報導見李建興(2025/1/30),〈爆紅中國AI服務DeepSeek資料庫配置錯誤導致機密日誌外洩〉,iThome。https://www.ithome.com.tw/news/167169 [7] eWeek(2025/8/1),〈ChatGPT’s Share Feature Let Private Chats Appear in Google Search〉。OpenAI 已於 2025 年 7 月 31 日移除該功能。https://www.eweek.com/news/openai-chatgpt-google-search-indexes/。中文報導見 T客邦(2025/8/2),〈你與 ChatGPT 的對話能被 Google 搜到?OpenAI 測試新功能惹議後緊急下架〉。https://www.techbang.com/posts/124672-chatgpt-conversations-indexed-by-google-removed [8] 行政院(2025/2/3)新聞稿〈公務機關全面禁用 DeepSeek AI 服務〉。https://www.ey.gov.tw/Page/9277F759E41CCD91/3ce9fe8f-2f5f-4d1d-8176-6fa4cf622b82 [9] 數位發展部資通安全署(2025/2/20),〈公務機關全面禁用 DeepSeek AI 服務,未限制一般民間使用〉,新聞稿指明禁用範圍「包含雲端服務、APP及地端下載等方式」,並說明目前未限制民間使用。https://moda.gov.tw/ACS/press/news/press/15296。另依行政院公共工程委員會〈採購契約範本附記條款特別聲明〉(114/5/20修正),須交付書面履約成果的政府採購案,履約過程亦禁止使用中國大陸廠牌之資通訊產品(含生成式 AI)。 [10] Hill, K.(2020/1/18),〈The Secretive Company That Might End Privacy as We Know It〉,The New York Times。https://www.nytimes.com/2020/01/18/technology/clearview-privacy-facial-recognition.html [11] OpenAI(2026/8/26),OpenAI – Hugging Face Incident Technical Report。https://cdn.openai.com/pdf/67869394-cb91-4c12-888c-5cbd85c7814c/OpenAI-Hugging-Face%20Incident-Technical-Report.pdf。據 CNBC 報導,參與事件的模型版本係在移除標準防護機制與分類器的設定下運行,與外部使用者所用版本不同。https://www.cnbc.com/2026/08/26/open-ai-hugging-face-hack.html [12] Anthropic 消費者帳號(免費、Pro、Max)自 2025 年起於註冊時選擇是否「協助改善 Claude」;開啟者,其對話經自動工具過濾或遮蔽敏感資料後,最長保留五年並用於訓練,未開啟者保留三十天。商業方案(Team、Enterprise 與 API)適用商業條款,預設不用於訓練;API 資料預設於三十天內自後端刪除。見 https://www.anthropic.com/news/updates-to-our-consumer-terms 及 https://privacy.claude.com/en/articles/7996866-how-long-do-you-store-my-organization-s-data [13] 價格參考:CloudZero(2026/9/14 更新),〈Claude pricing in 2026〉,https://www.cloudzero.com/blog/claude-pricing;eesel AI(2026/7/12),〈ChatGPT for Work pricing: Business & Enterprise cost (2026)〉,https://www.eesel.ai/blog/chatgpt-work-pricing;eesel AI(2026/5/7),〈Copilot pricing 2026〉,https://eesel.ai/blog/copilot-pricing。以上為第三方整理,實際價格以各公司公告與報價為準;新台幣以 1 美元約 32.5 元概算。立案之非營利組織可經科技濃湯(TechSoup Taiwan)申請各公司的非營利捐贈或優惠方案,見 https://www.techsouptaiwan.org/;各方案內容時有調整,例如微軟已於 2025 年 7 月起停止免費的 Business Premium 捐贈授權,改為折扣的付費方案。 [14] 依筆者團隊 2026 年 10 月的初步估算:開源模型中最接近前沿商業模型者,即使經量化仍需約 400 GB 以上的顯示記憶體;其綜合能力依公開彙整的評比,仍與前沿模型有可見的差距,僅供量級參考。以商業 API 處理一次紀錄撰寫或督導分析,約讀取兩萬、產出三千個詞元(token),成本約 0.07 美元(約新台幣兩元餘)。 [15] 《個人資料保護法》第2條第1款。該法修正條文於 2025 年 11 月 11 日公布,將設立個人資料保護委員會為統一主管機關,施行日期由行政院另定。見曾更瑩、開政道(2025/11/11),〈總統公布「個人資料保護法」修正條文〉,理律法律事務所。https://www.leeandli.com/TW/NewslettersDetail/7532.htm [16] 例如《心理師法》與《社會工作師法》均有關於業務上知悉他人秘密之保密規定;護理、法律、教育等其他助人專業的法規與倫理守則,亦多有類似要求。 [17] 行政院(112/10/3),〈行政院及所屬機關(構)使用生成式AI參考指引〉,院授科會前字第1120059686號函。https://www.ey.gov.tw/Page/448DE008087A1971/40c1a925-121d-4b6b-8f40-7e9e1a5401f2。另行政院公共工程委員會於〈採購契約範本附記條款特別聲明〉(114/5/20修正)中,亦要求得標廠商不得向生成式 AI 提供涉及公務應保密或個人之資訊。 [18] 《人工智慧基本法》於民國 115 年 1 月 14 日公布施行;行政院於同年 5 月 21 日提出施行規劃,要求各級政府機關於當年 7 月前完成公務使用 AI 之風險評估,並於一年內訂定內控規範。https://www.ey.gov.tw/Page/9277F759E41CCD91/999df6da-6539-4941-913f-5125d684c58d。數位發展部〈人工智慧風險分類框架〉於同年 7 月 7 日公布,列有「影響隱私與違反個人資料保護法規」之風險類別。相關報導見羅正漢(2026/7/9),〈數發部正式公布人工智慧風險分類框架,畫分3大類20項子類別,並提供4大建議步驟〉,iThome,https://www.ithome.com.tw/news/177184。 [19] 衛生福利部(115/5/29),〈醫療機構應用生成式人工智慧指引〉,衛部醫字第1151663164號函。屬行政指導性質,要求委外建置之系統於合約中規範資料不得外洩或另作他用,並由醫事人員對涉及臨床判斷之內容做最終確認。該指引適用於醫院與診所,並未明文禁止將個資輸入生成式 AI,而是要求導入前進行資料保護評估,並依個資法檢視資料的蒐集、處理與利用。 [20] 教育部(115/6/5),〈高級中等以下學校人工智慧使用和學習指引〉,臺教資(一)字第1152701618號函。 [21] 游琇婷、游廷碩(2026),〈生成式人工智慧與大型語言模型在心理學研究中的方法論意涵:推論條件與推論邊界的再界定〉,《中華心理學刊》,68 卷 2 期,頁 107-124。DOI: 10.6129/CJP.202606_68(2).0003 [22] 利益揭露:筆者所屬之國立清華大學人文社會AI應用與發展研究中心與 AIFR 研究群,開發有「校園輔導/諮商 AI 增能平台」與「AI社工紀錄輔助系統」,皆屬非營利之學術開發;前者經費來自國立清華大學研發處(教育部高等教育深耕計畫)。兩者皆無須註冊登入。增能平台中供學生使用的「小慢」系列,採部署於校內伺服器的地端模型;供心理師使用的個案分析輔助系統,因涉及長文本分析與多代理架構,目前透過 Anthropic Claude API 處理,對話於二十四小時內自動清除,並提醒使用者以化名或去識別化方式描述個案;對話不用於模型訓練、研究或商業用途。AI社工紀錄輔助系統的配置見 6.3 與表六。依第六節之分級,上述系統應是屬於部分達到進階級的標準,但目前皆尚未簽署零資料保留協議,是後續改進方向。本文所提標準並非為這些系統而設。詳見 https://mentalai-webportal.phys.nthu.edu.tw/disclaimer 及 https://hssai-socialworker.phys.nthu.edu.tw/ [23] 美國社工協會(NASW)倫理守則第 1.04(d) 條:社工若於提供服務過程中使用科技,應確保具備相應的知識與技能以勝任該服務。https://www.socialworkers.org/about/ethics/code-of-ethics/code-of-ethics-english;另見 NASW、ASWB、CSWE 與 CSWA(2017),Standards for Technology in Social Work Practice。https://www.socialworkers.org/Practice/NASW-Practice-Standards-Guidelines/Standards-for-Technology-in-Social-Work-Practice。原則排序見 Dolgoff, R., Harrington, D., & Loewenberg, F. M.(2012),Ethical Decisions for Social Work Practice(9th ed.),Brooks/Cole,依序為:保護生命、平等與差別待遇、自主與自由、最小傷害、生活品質、隱私與保密、真誠與充分揭露。 [24] 關於「AI 公共化」的論述,見王道維、林昀嫺(2020/8/14),〈如何用AI創造社會共善?──AI公共化的契機〉,台灣人工智慧行動網,https://blog.udn.com/dawweiwang/148733003;林文源、王道維(2023/2/22),〈淺談AI時代的台灣優勢與發展策略〉,風傳媒,https://blog.udn.com/dawweiwang/178443462;王道維(2024),〈從AI公共化來看政府、學界與民眾的角色〉,收於《AI在服務領域應用》,中技社,https://blog.udn.com/dawweiwang/180885309;王道維(2025),〈被企業壟斷的AI?達成社會共善的AI公共化願景〉,《科學月刊》第 666 期,https://blog.udn.com/dawweiwang/182720193。 [25] 關於 AI 時代判斷力與素養的架構,見王道維,〈從零散應對到系統深耕──在後知識時代一份供大學自我檢視的人才培育架構〉。https://blog.udn.com/dawweiwang/188331743
(全文完) |
|||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||
| ( 知識學習|隨堂筆記 ) | |||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||||