字體:小 中 大 |
|
|
|
| 2026/11/22 02:43:27瀏覽51|回應0|推薦0 | |
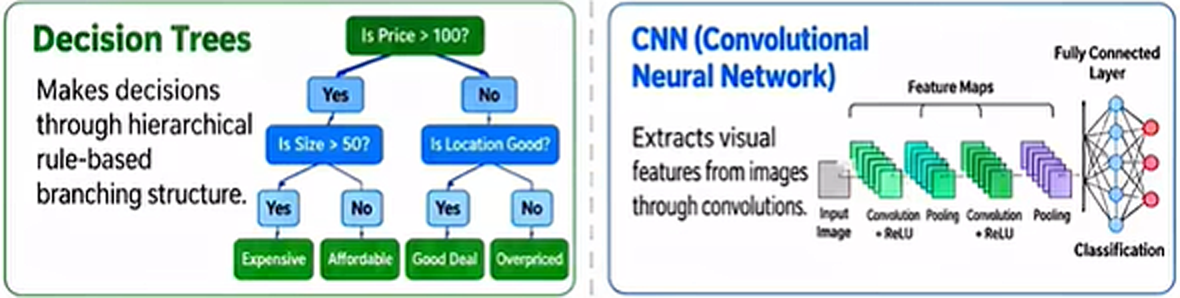
https://www.facebook.com/reel/1879524743212270 從友人介紹的網頁上截取到上面這張兩個AI方法的示意圖,我最近一直掛在嘴邊的Rule based方法基本上就是左邊的Decision Trees了!如果寫成程式就會是一大堆的If…then…else之類的條件式。我目前的手寫數字辨識核心內就至少有上萬個這種條件判斷式! 相對的CNN的基礎就是for…next之類的層層疊疊的迴圈了!對於影像來說,CNN的Convolution計算某一點的權重,就是一個雙層的迴圈,掃描全圖的程式就是四層的迴圈了!計算量就已經超過百萬個條件式了!而且Convolution通常是要做好多次的!所以跟傳統非CNN方法的效率落差才會那麼大! 正因為CNN的計算量實在大到天怒人怨人神共憤,即使有多核心CPU都還不夠它們揮霍,即使再加上輝達的GPU加持都還是非常窒礙難行,所以才會出現甚麼RNN與YOLO之類的「進階」CNN演算法,努力減少一些運算量!但是在這個Convolution的架構不變的前提下,他們不願意提的事實是:計算量還是遠遠大於傳統方法(如Decision Trees)至少數百倍! 所以CNN先天上就是一個非常沉重的概念!傳統的影像辨識是先用灰階二值化等不需要矩陣運算的方法,嘗試分割出一些獨立目標後針對這些獨立目標分析特徵!CNN則是建立一個想要找的特徵的特徵矩陣去全圖搜索掃描,建立全圖的特徵權重!這兩種過程的耗時就是數百倍的差距了! 也因此,如果在可以「不必用」CNN的情況下,我們可以找到以傳統的影像辨識方法解決問題時,就表示可以省下非常多計算量,大幅減少設備需求與營運成本的意思!這就是我最近在努力的事情!我用非CNN的方式做到了MNIST字集的極高辨識率,至少與頂尖CNN的辨識率不相上下,但是計算量少了千百倍! 如果決策樹(Decision Trees)的方法存在的時間比CNN更久,為什麼以前的人沒做到我現在的成績呢?我覺得關鍵就是我的創新概念,所謂的福爾摩斯法了!正常傳統的決策樹是逐步從大原則到小原則分類,逼進到最終的正確答案的!對於手寫數字0-9的判斷,我的決策樹使用方式幾乎是完全相反的! 我其實是使用很細小很限制性的特徵組合來逐步剔除「最不可能」的答案!而且不是同時比較0-9十個字的特徵,只是依序比較兩個數字擇一淘汰,所以規則的設計不會太複雜到難以掌控,二選一決定比較像誰?就單純容易多了!當可能的答案被排除縮減到只剩下一個時,就是辨識流程的終點了!這跟傳統上的二分逼近法,逐步逐層做分類的概念是非常不同的!但事實證明在辨識模糊的手寫數字上是有用的! |
|
| ( 心情隨筆|工作職場 ) |