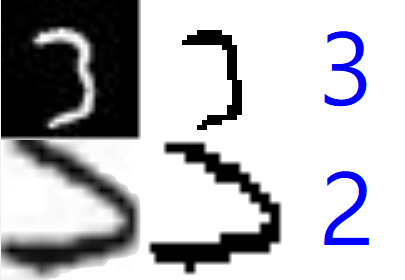字體:小 中 大 |
|
|
|
| 2026/11/19 11:29:33瀏覽40|回應0|推薦0 | |
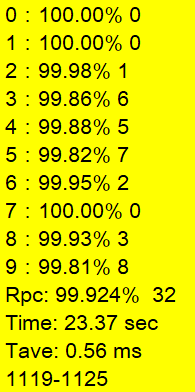
我的辨識核心在MNIST字集的基礎上拚到了99.924%的高辨識率,但是過程中已經心知肚明,為了爭取99%以上的辨識率,許多案例已經有點違背我自己對數字特徵的基本認知,就是機器學習派常說的Overfitting了!那些有點過度牽強的辨識原則,當然是可能造成潛在危機的! 所以我不會認為在MNIST基礎上獲得極高辨識率的辨識核心,就是神聖不可侵犯的終極聖經版本!最終的最佳辨識模型一定還是以符合人的普遍認知為目標的!但即使是那些略微過度解釋的MNIST案例,如上面的3字,少了3中段應有的轉折,一般人還是會認為是比較像3不是2,所以我還是設計出辨識條件讓它可以被視為3,結果就是上圖下我從一般文件中擷取出來的2也會被辨識成3了! 此時合理的作法當然是進一步分析兩者的差異!一般人的認知應該都是認為是上3下2無誤的!Rule based的精神就是研究出如何區別兩者的差異,據以建立出額外的Rule(s)來分辨它們!我就是這麼作的!很顯然它們還是有明顯差異的!前者的中段長而直,後者中段是急轉彎,這就足以清楚分辨它們是2或3了! 這跟機器學習的做法就很不一樣了!他們的精神是找出「統計」上的任何微小差異!所以如果這種奇怪特殊的案例數沒有成千上百,它們是很難統計出穩定的辨識機制的!但實務上這麼特殊的字不會太多!所以「理論上」只要資料夠多就可以經過訓練學習辨識這種差異,但實際上總是做不到的! 相對的,Rule based方法可以在只出現一個案例時就進行研究,找出符合人類認知的邏輯!以這種Rule加入辨識流程,預期結果是不會太離譜的!怕在「統計」上出問題嗎?就是新增的Rule影響到其他我們沒想到的狀況,造成更多的辨識錯誤嗎?那就學機器學習作整個MNIST字集的全面測試嘛! 因為Rule based辨識流程的高效率,所以做全面測試跑幾萬張資料集中的案例只要幾十秒鐘的!如果發現辨識率走鐘就再研究調整,如果辨識率不變呢?就是找到穩定可靠的新Rule,可以立即做軟體的新版升級發布了! 我的這個調整就可以完全不影響之前獲得的辨識率,還是MNIST的99.924%!這就是我接下來在真實文件中發現辨識錯誤時的標準處理程序了!不會像機器學習一樣,發現例外錯誤想優化模型,就必須重新做耗時的全程訓練,再重頭摸索一次的!這也是Rule based與ML/DL/CNN方法在研發成本上的極大差異!我只花二十幾秒就驗證完成我的新模型沒問題了!所以找我做這類影像辨識專案的價錢也不會太高的!正所謂賓主盡歡!
|
|
| ( 心情隨筆|工作職場 ) |