字體:小 中 大 |
|
|
|
| 2026/11/11 09:14:44瀏覽20|回應0|推薦1 | |
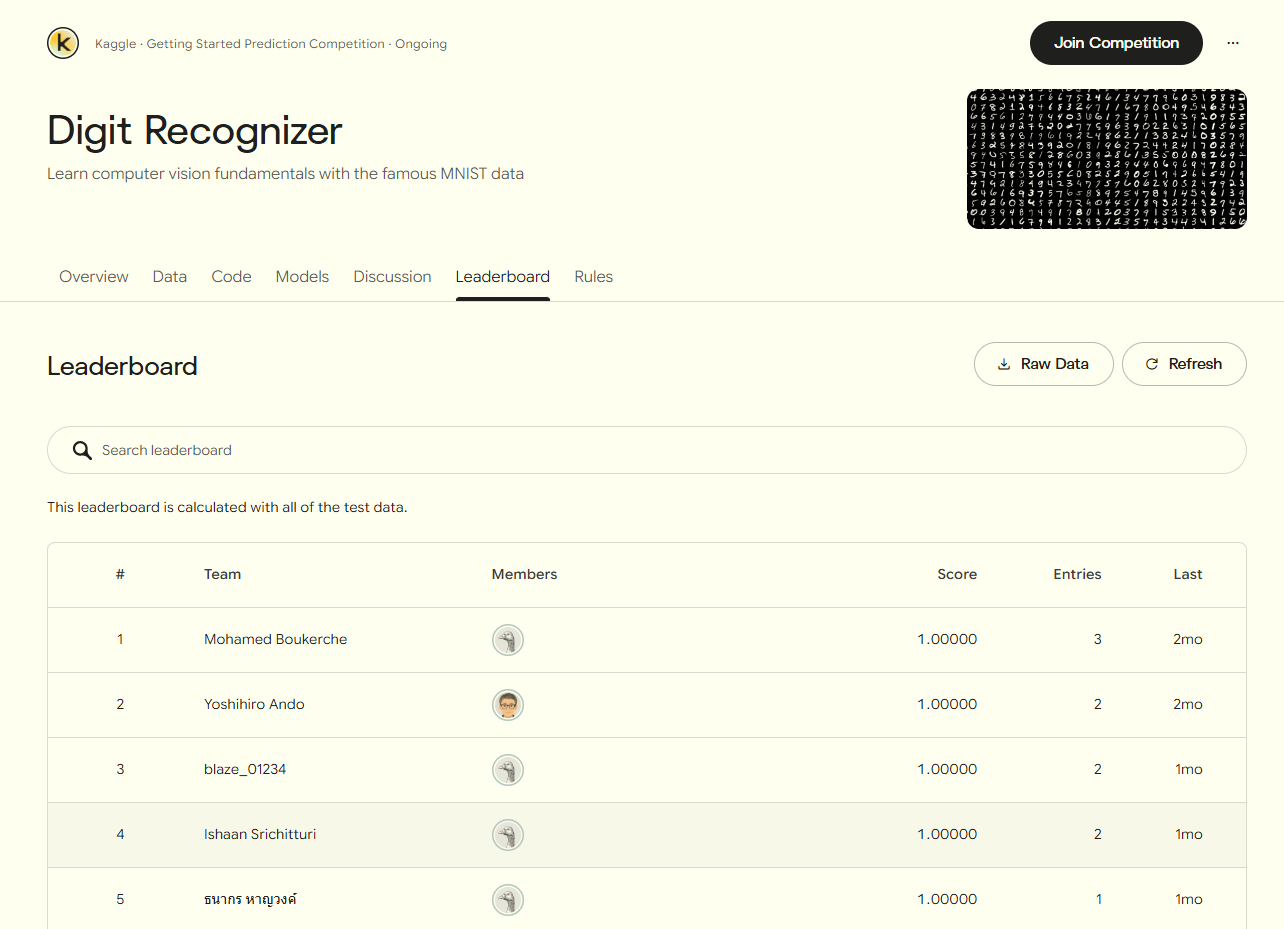
剛剛找到這個MNIST手寫數字辨識率的評比網頁,才發覺這個辨識率遊戲其實已經被玩爛玩壞了?排行榜上前18名都是100%的辨識率?我的99.924%只能排到第27名?可見跟我之前想像的一樣!只要有標準答案的資料庫,努力玩「湊答案」的遊戲總是可以拚到極限高分的!機器學習就是湊答案的技術嘛!只要願意無限提高算力與擴大模型,總是可以達到滿分的! 這是一個自行上傳資料的排行榜,所以審查機制可能不太嚴謹,所以我問Google AI時,他說的最好成績(99.879%)大概是不會看這個榜單的!應該是來自某些有嚴謹考核監視的比賽成績吧?我既然沒參加比賽,所以大概也只能被歸類成這種自說自話的成績爛帳之一了? 比較不同的是:他們都是在使用ML/DL/CNN的玩家,我則是硬橋硬馬的Rule based研究!而且真的提供了測試軟體讓大家下載測試!所以可信度當然不可同日而語!或許也因此,Google AI與Bing AI都真的把我的報告當一回事!他們有如實報導我宣稱的辨識率,但沒有理會(相信)這個榜上高達18個100%的紀錄! 但是我覺得這些都不重要!重要的是這個現象已經充分證明了ML、DL與CNN其實只是一個根據標準答案硬湊答案的遊戲!只要有題庫,也有標準答案就一定可以經過充分的「訓練」與龐大的模型,拼湊出極高辨識率的結果!跟甚麼影像辨識的技術原理一點關係都沒有!那些達到100%辨識率的玩家,應該根本對影像辨識一無所知!只是很會玩湊答案遊戲的超級玩家而已! 如果這樣就真的可以達到影像辨識的實務需求,其實也無可厚非!但事實上就是辦不到!首先是資料集再大都跟真實世界有差距,MNIST字集100%辨識率的模型未必比95%的模型在真實世界表現更好!真實世界如何辨識是甚麼字的Rules當然還是非常重要的!但是ML/DL/CNN的方法完全沒參考這些! 更重要的關鍵是:效率!ML/DL/CNN拚出高辨識率的代價就是無限擴充模型,增加變數!讓計算量變成天文數字!最後讓這些ML/DL/CNN模型變成龐大笨重速度很慢還超級耗電的怪獸!辨識率高又怎麼樣?一般電腦跑不動,成本太高無法商業化,高辨識率的好成績意義何在? 所以我在做這個研究之初到現在,一直都在強調辨識率只是一個門檻!我的主要目標不是「贏過」ML/DL/CNN!如上面那排行榜,他們總是可以湊答案到100%的!我的目標是讓我的Rule based方法辨識率「跟得上」ML/DL/CNN!只要Rule based方法不要因為太低的辨識率被放棄,他任何方面都優於ML/DL/CNN! 首先當然是數十倍的高效率,其次是Rule based是透明的白盒子,ML/DL/CNN是黑盒子!對於軟體日後的升級維護,成本效益差距更大!白盒子很好維護升級,黑盒子呢?那就是軟體商營運上的噩夢了!所以大家體會到我的核心理念與動機了嗎? 我不在乎有一大堆ML/DL/CNN玩家的辨識率比我高!那是必然的!重點是我的辨識率完全不輸那個頂尖的等級,99%辨識率就已經非常足夠了!因為辨識率之外的其他方面ML/DL/CNN本是不堪一擊的!只有想賠錢倒店的廠商才會選擇辨識率差不多,但貴上幾十倍的M/DL/CNN解決方案的! |
|
| ( 心情隨筆|工作職場 ) |