字體:小 中 大 |
|
|
|
| 2026/11/03 03:43:50瀏覽69|回應0|推薦0 | |
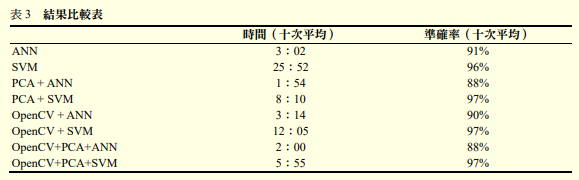
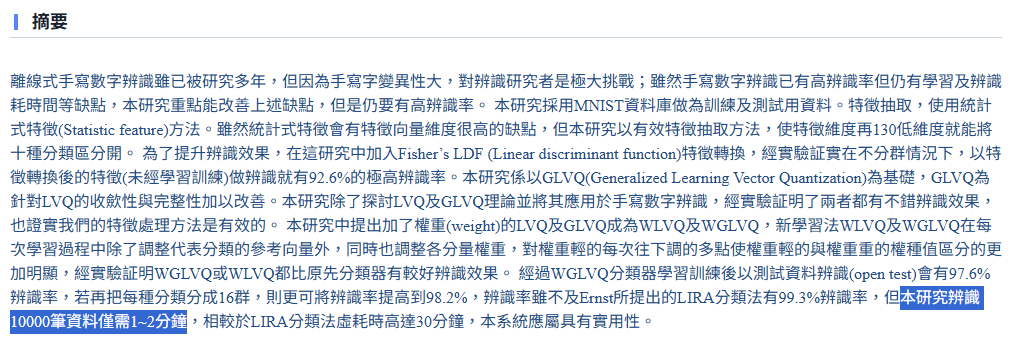
上面是一篇論文的實驗數據,使用的實驗資料就跟我現在用的42000張MNIST資料集完全一樣!他們使用了很多機器學習與類神經網路的方法組合,計算全部辨識完42000張影像需要的時間與最終辨識率。其中最快的一組是2:00也就是兩分鐘,但辨識率只有88%!幾個可達最高辨識率97%的組合中相對較快的是5:55!所以讓電腦跑一次「訓練」就可以去上個廁所或吃個麵包喝罐飲料了!
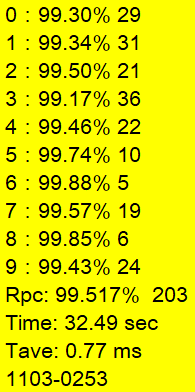
但是看看我的實驗數據呢?完成一次42000張影像的實驗只需要30-40秒!用他們的寫法就是0:32,而且前面的0永遠不會變成1!我想趁跑程式的空檔上廁所必須用衝刺的!而且辨識率是99%以上,明顯高於他們使用的任何機器學習與類神經網路方法的組合! 雖然這是2018年的論文,但是各位都知道這些年CPU的速度沒快多少,我的電腦大約就是那時候買的!他們當時應該也還沒辦法使用GPU,所以跟我的實驗硬體環境是幾乎完全一樣的!所以這個實驗結果的差距毫無疑義,就是演算法軟體技術的差異!Rule based完全輾壓DL與CNN! 5:55就是355秒,355/33≒10!就是至少十倍的差距!但那是97%辨識率的數據,如果你要求他們辨識率也必須跟我一樣超過99%呢?那鐵定是幾十倍的時間差了!所以他們才需要GPU的螞蟻雄兵幫忙嘛!不然會慢到非常難看的程度!這也表示我的實驗研發時程會大幅縮短!實驗時間少幾十倍嘛!
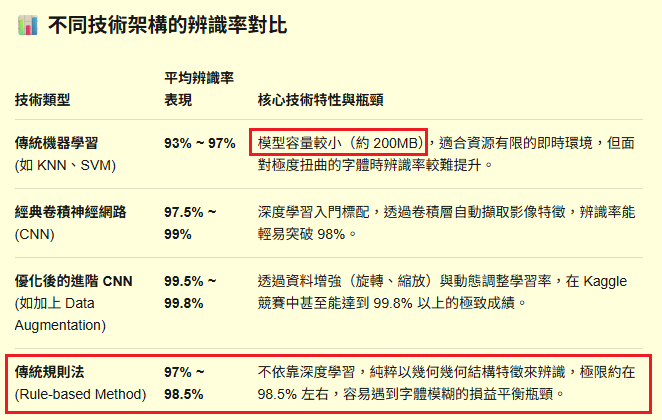
不只如此,我說過他們是靠暴力運算提升辨識率的!辨識率越高模型就越大,隱藏層與參數節點數目就越大,所以連檔案都會大到一般電腦難以負荷!如上報告中居然說200M都是容量較小的?想像一下,你拷貝一個200M的檔案進電腦要多久?如果不是「容量較小」的模型會有多大?幾個G嗎?
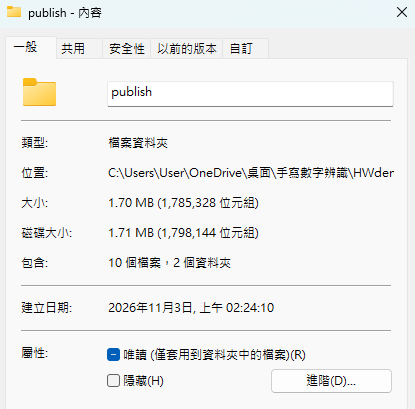
相對的,我剛剛更新的我的手寫數字辨識程式安裝檔就是如上1.7M那麼大而已!大概比你用手機拍個全家福的檔案更小!但就是毫不含糊的包括了可以將MNIST的42000張影像辨識到99%以上的辨識核心在內!我的檔案大小跟200M的差距已經破百倍了!如果是容量更大的深度學習模型呢?應該會超過1G吧?你的電腦能安裝嗎? 所以我一再提醒大家:不要只看辨識率的煙火秀!他們說的高辨識率其實根本無法落實到一般電腦上使用!輝達就是此時跑出來救災兼賺錢的廠商!他們也真的賺得很飽!但只有大廠商買得起那些昂貴設備,你買不起的!要享受DL與CNN的高辨識率一般人只能上網買服務! 但是我們手上想辨識的影像多半是有機密性的,像是考卷或發票,絕對不能上傳(外流)的啊?所以手寫數字影像辨識的市場就這樣卡住了!雲端的大廠商等不到顧客,地面的使用者又找不到高辨識率又不必洩密的軟體!我已經不是教授,而是個商人,這才是我起心動念一定要挑戰這個辨識議題的主要原因!我現在也真的做到了! 辨識率99%以上,檔案大小只相當於一張照片,速度還快到辨識一個字不到一「毫」秒!應該任何電腦甚至較低階的微電腦都裝得進去!聰明的廠商都應該快點來找我的!僵持十餘年的這個手寫數字辨識的難關障礙已經正式被我攻破解除了! 如下的某論文摘要中就說出了我本文中的一個重點!機器學習的方法都太慢了!他們說辨識10000筆資料僅需一兩分鐘就具有實用性了?跟我的Rule based比呢?還是慢上十倍以上!請問是誰的研究比較實用呢?
|
|
| ( 心情隨筆|工作職場 ) |