字體:小 中 大 |
|
|
|
| 2026/10/30 15:53:25瀏覽354|回應0|推薦3 | |
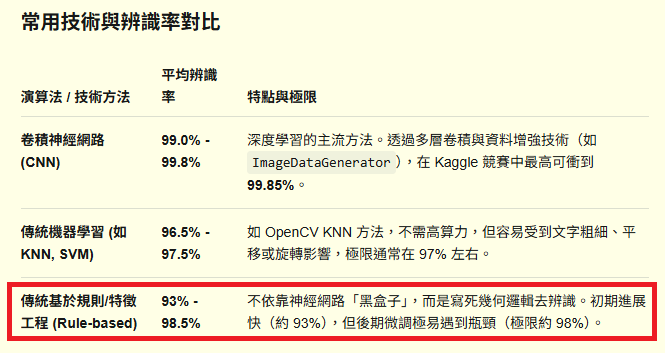
很高興看到Google AI的報告中終於將Rule based方法的辨識率重新加入這個比對表了!幾天前還沒有的!完全只有機器學習的方法!很顯然的就是因為我的98%以上的高辨識率讓Google AI已經無法忽視我的存在了!但是報告中的語氣顯然還是偏袒深度學習,還是堅持說那才是「主流」方法?好像只要我的辨識率壓不過DL,我的Rule based就始終難登大雅之堂?好像土博士就是先天上比不過洋博士?還好我已經很習慣被歧視了! 雖然我知道在實務上追求MNIST為基準的辨識率,只需要大於98%就應該夠用了!更高的辨識率只是看你能刻意附和MNIST的標準答案到什麼程度?對於最終軟體在真實界的辨識率幫助不大,甚至可能有局部的負面作用?但畢竟那也是一種技術指標,最近的研究中,我也發現用我的Rule based方法也一樣可以做這種刻意配合標準答案的設計!或許還比深度學習做得更好?所以到了99%之後我放心做那些特例的調整,辨識率還是繼續提升中。
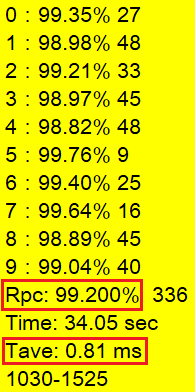
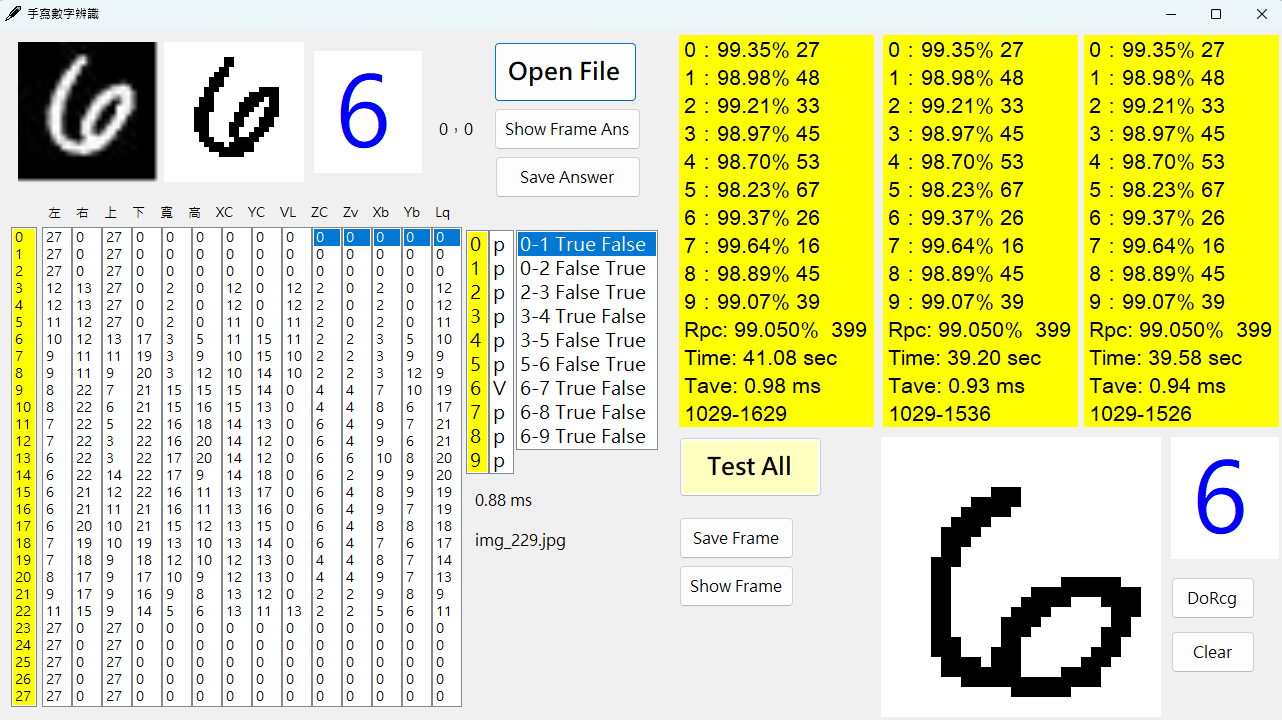
上面是我目前的進度!好像不太費力就提升到99.2%了!感覺上還可以繼續突破很多案例?做到99.5%好像是沒問題的,如果可以衝高到99.85%就是世界冠軍了!如果可以虛榮一下也不錯的!我目前尚未克服的案例數是336個,我算過要到98.85%就是只能錯63個案例!336-63=273!就試試看囉! 當然還是要強調辨識率的比拚只是爭一口氣!證明Rule based完全不會輸給深度學習!但更具體實質的意義要看上圖中的辨識時間!不管我的辨識率提升到多少,使用Rule based的架構優勢,就是可以還是只用極少的運算量完成辨識!一個案例還是只需0.81毫秒!這一點深度學習就真的跟我完全沒得比了!輸到見不得人了! 下圖就是現在每天陪伴我的實驗介面了!可以一一研究每個案例的辨識過程細節,有了可用的新版就立刻做42000張的整體測試(訓練),在Debug模式下只需要大約40秒,改用Release模式當然就會縮短到約34秒!所以我的「訓練」過程很輕鬆,一天可以研究近百個案例,作數百次的改版!所以辨識率的推進才會那麼快!而且只是用我自己的一般規格電腦,連多執行緒的平行運算都沒用到!就是只用到CPU的單核心啦!就已經這麼快了!好同情深度學習的使用者,一定會累死了!你們訓練一次要多久啊?還必須買輝達的超貴電腦齁?
|
|
| ( 心情隨筆|工作職場 ) |