字體:小 中 大 |
|
|
|
| 2026/10/26 02:05:07瀏覽74|回應0|推薦1 | |
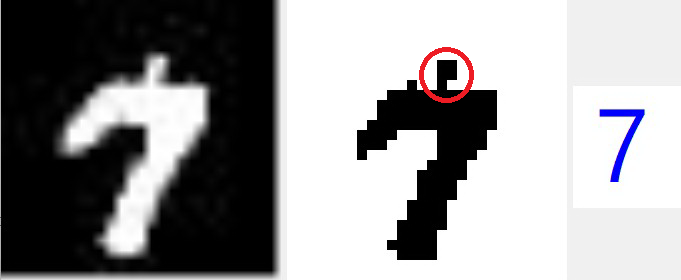
我之前好幾次說,超過99%的MNIST手寫數字辨識率應該都是不合理的Overfitting的結果!我也曾在FB上宣稱:要這麼玩?我的Rul based方法也可以用不合理的Rules做到Overfitting的效果來硬抝辨識率的!上面就是一個明顯的例子,我目前也真的這麼做了! 上面7字上方凸出的角毫無疑問是個無意義的隨機誤差!不管是7或9或任何字都不應該有這特徵,但是MNIST字集中不巧就是有這一個7字有這個雜訊,其他案例都沒有!所以當我的軟體用其他特徵無法判斷它是7或9時,我就作弊了!刻意加入這個特徵,頭上長角的就算是7了!我的辨識率就因此提高了! 這個頭上是否有角的不合理辨識原則,就是一個典型的Overfitting了!日後使用到MNIST以外的真實案例時,如果有一個9也剛好形狀類似又剛好有這種雜訊,我也會說它是7的!Rule based的設計者是人,人是有道德良知的!會覺得設計這種不合理的特徵是不對的!不科學的!所以通常不會做! 但是機器學習呢?他們沒有人類的道德良知或科學概念的自我約束!只以湊出資料庫認定的標準答案為目標,簡單說就是「無所不用其極」的為求高分甚麼不合理的方法都會毫無顧忌的立即使用!但是基於訓練資料與答案建立的不合理原則到軟體實際使用時會有多大影響?就是一個不易掌握的地雷了!我是讀過建中的,在當年無理性的激烈升學競爭中這種不顧事實的無恥心態見多了!
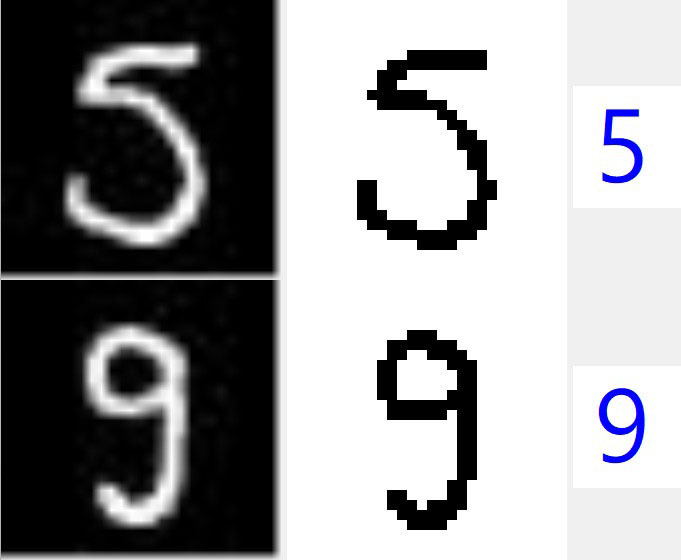
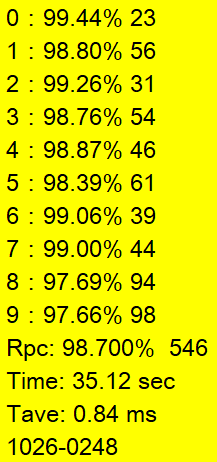
其實上面頭上是否長角的Overfitting應該對日後的實際辨識影響不大,這種雜訊極少出現的!但是你知道如上兩個案例都是MNIST宣稱是「3」的案例嗎?顯然任何地球人都無法同意它們是3!這就是我說MNIST之中有很多明顯不合理的答案的例子!但是機器學系派人士稱它們是「Ground Truth」字面意義就是「不可爭議的事實」!很可笑吧? 如果我是使用Rule based方法建構軟體,我是有常識的人類,所以一定不會接受這個明顯錯誤的答案,絕對不會依據它們來建立任何認定是3的字形特徵的!但是機器學習當然沒有這種常識(或是道德良知?),一定會囫圇吞棗硬是把它們當作是3來訓練模型的! 此時就是他們說的「監督式學習」可能介入的時候了!其實就是用人類的常識、直覺或科學觀念強制排除這些明顯不對的做法。所以監督學習不是甚麼更優良的改進方法?只是補救機器學習無法控制的大缺點的救災措施而已!這些失控狀況如果是使用Rule based方法,根本就不會發生的! 所以你還要說機器學習比Rule based更AI嗎?差得遠了!要比「智慧」當然是Rule based遙遙領先的!但是如果為了拚成績做些無傷大雅的Overfitting呢?Rule based方法也可以做到的!我現在從如下已達98.7%的辨識率,還想再衝高一點突破99%,就會不時碰到是否增加一些這種不影響大局的Overfitting的抉擇?如果我做了!不要苛責我!這只是讓這個比賽更公平一點而已,因為對手都是這麼作的!我不必因為這點潔癖被對手取得不合理的優勢,如此而已!
|
|
| ( 心情隨筆|工作職場 ) |