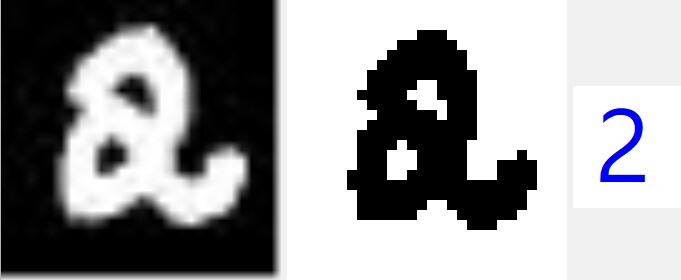字體:小 中 大 |
|
|
|
| 2026/10/24 06:15:00瀏覽111|回應0|推薦1 | |
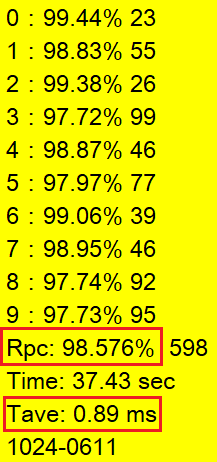
我的手寫數字辨識已經推進到MNIST標準的98.576%了!颱風天還是繼續玩這個非常好玩的辨識遊戲,看到有趣的案例借題發揮寫個短文就是我的休息時間了!如上是個我原本完全不抱希望的絕症案例!但是現在卻可以準確辨識為2了!當然MNIST也同意的! 藉此我可以透露一個我的新方法的特色,就是我的辨識原則非常偏向定性而非定量!我想不管是機器學習或Rule based方法的使用者都沒我這麼極端的!譬如看到兩個封閉區間就是明顯的8字的特徵,看到一個神龍擺尾呢?就是很明顯的2字特徵了! 那如果這兩個特徵同時出現呢?傳統學術訓練的想法應該是傾向找出兩者的量化權重,就是嘗試分析哪一個特徵更「顯著」!但其實我不認為人的腦袋會真的這麼運作的!人腦是很厲害,但是精確量化的能力並不太好!所以我認為人腦會根據特徵的衝突性選一個定性上「比較重要」的特徵,而忽略另一個! 上面就是一個很棒的例子!一般人都一定會選擇相信那個神龍擺尾的特徵比較重要!不太可能有人寫8字會畫個大尾巴的!但是當墨水太多筆劃太粗時,寫2是比較有可能產生無謂的封閉區間的!所以兩個特徵根據定性的比較,我的辨識軟體應該相信這是個2而不是8! 關鍵就是我的這個程式中幾乎都是這樣以定性優先,定量為輔的!如果你讀過夠多的相關論文就會知道這真的是非常「離經叛道」!這其實也是機器學習方法最弱的一環!他們就是統計學嘛!所有特徵都必須建立成量化指標!所有決策也都必須依據綜合的量化指標!定性決策是必須依賴科學定理原則的邏輯建構的!機器學習本身沒有這種知識! 所以我的辨識率可以有大突破絕對不是偶然!真的是有非常不同的創新概念在裡面!也因為極少仰賴量化指標,數值計算量就相對很少,一萬多行的程式幾乎都是If…then…else的判斷式,極少迴圈計算!所以速度才會那麼快啊!這是DL與CNN最大的痛點!我就是想盡情地踩他們的痛腳!
|
|
| ( 心情隨筆|工作職場 ) |