字體:小 中 大 |
|
|
|
| 2026/10/21 12:25:54瀏覽366|回應0|推薦3 | |
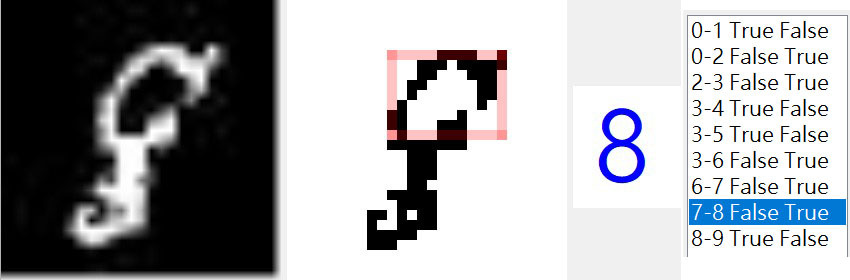
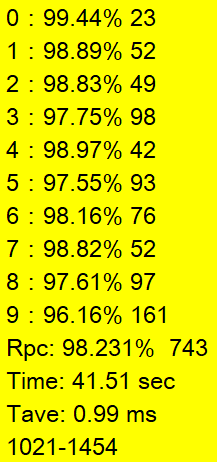
我的手寫數字辨識率已經繼續推進到MNIST標準的98.23%了!現在真的很像陷入了膠著的巷戰!每天能提昇的幅度極小,甚至完全停滯!就是逐一檢視辨識失敗的案例,看看失敗的原因,最簡單的處理方式是看能不能刪除導致失敗的那個邏輯條件?如果刪除後得不償失,因此產生更多失敗案例當然就不能刪了! 當然也可以調整辨識條件的參數門檻,或是調整諸多條件使用的先後順序,實在都無法得到更佳的結果時,就要設計加入新的辨識條件了!這些過程也可以套用到機器學習的術語,說是在「訓練」我的「模型」!但是我的工作內容比他們具體有意義多了!我真的是在研究辨識影像的邏輯,那些ML、DL與CNN的使用者呢?只是在盲目調整自己都不知道有何辨識意義的統計參數而已! 雖然說都是Rule based辨識,我用的方法跟大多數我知道的Rule based方法有很大的不同!多數辨識架構是正面表列的!就是看看建立的特徵與案例的符合程度來加減分,看看把它當作0-9的哪個數字分數最高就是答案了! 但是我採用的方式完全不同!事實上我從頭到尾都沒有建立任何一個案例的加權總分!而是如上圖右方所示,依序假設它是0或1一直到8或9的比較!較「不像」的數字就會逐步被淘汰,直到剩下最後一個選項就是答案了!如上的8就是經過漫長的淘汰賽最後勝出的結果,也符合MNIST提供的標準答案! 可以看出來這個案例本身很破碎,如果要依靠它「像是8」的特徵來計分?分數一定很低!而且各個特徵的總分要如何相加才能做得公平?非常困難!所以傳統上計算總加權分數的方式都做得不好!我的構想就是反向思考!顛覆傳統,不計算總分,而是讓數字兩兩捉對廝殺!重點是「比較不像」的答案會被先淘汰!好像大風吹的遊戲,搶不到位置的人就逐一被淘汰出局,搶坐到最後一張椅子的就是贏家了! 為什麼前面幾十年那麼多人使用Rule based的概念做這件事都只能做到60-80%?我卻可以大幅突破?關鍵就是我沒有蕭規曹隨緊跟著前人走,也陷入一樣的窠臼!如果很多人做了幾十年都做不好,那就是方法概念上必須革命了!所以現在大部分的人都擁抱機器學習去了!但是我不喜歡機器學習「不知而行」的迷糊仗!所以有此大膽的創新,也獲得了不錯的成效! 另一個有趣的聯想是:如果我還在學術界當教授,是絕對不可能這麼作的!因為那時候所有研究工作都會以爭取計畫或讓論文審查通過獲得刊登為目標!消極面需要評審專家們都看得懂,積極面還要他們贊同認可!我如此離經叛道的極端創新?幾乎是不可能通過審查的!所以在發想的第一時間就會自我否決了!連試都不會試的!但是配合評審的口味亦步亦趨呢?一定不會有大突破的! 所以現在是自由之身感覺真的是好極了!就是大鵬鳥高飛天際時感慨「燕雀安知鴻鵠之志」的感覺!我已經不是在地面爭食腐鼠(國家資源)的一般燕雀教授了!只要能用實力做出有用的軟體賺到錢,我愛怎麼飛就怎麼飛!所以更有機會看到新的境界!做個我自己期望的科學家!
|
|
| ( 心情隨筆|工作職場 ) |