字體:小 中 大 |
|
|
|
| 2026/10/17 01:32:10瀏覽210|回應0|推薦2 | |
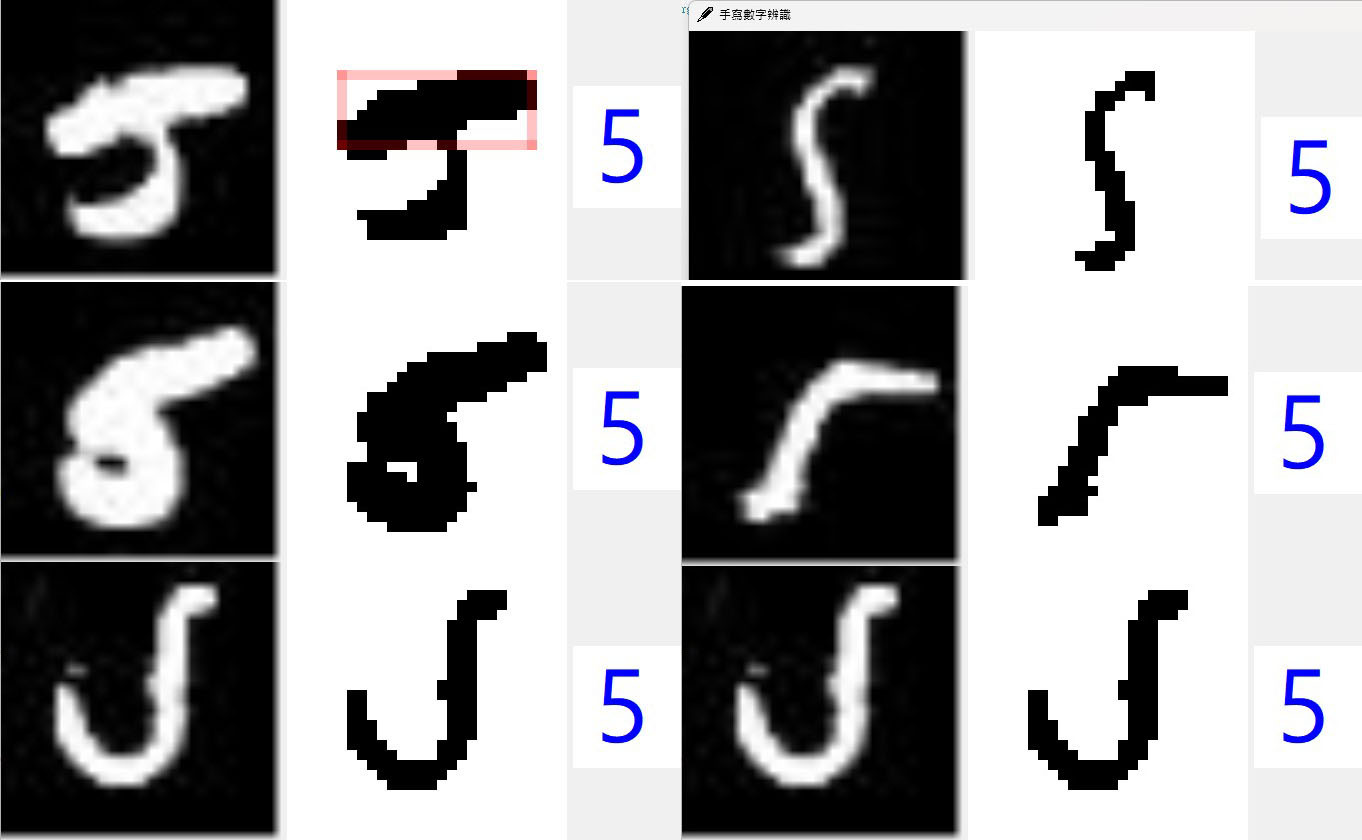
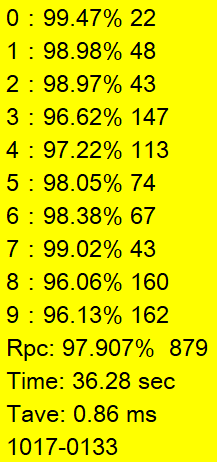
昨天有段時間專注在數字5的辨識,救回了好多如上連我自己都認為不可能辨識成功的Mission impossible!事實上當我的辨識率到MNIST標準的97%以上時,我已經覺得快到我的天花板了!但是這幾天居然還是繼續穩步前進,目前已經非常接近98%了!情況就是這類奇蹟還不斷的發生! 這種狀況真的是出乎我原本的預料!我以為當眼睛可以判斷的特徵都用完時,大概那些根本不具備該數字基本特徵的案例就是絕症死棋了!但是我沒想到的是:十個數字的辨識是相對且有範圍的!也就是在剩下的可能答案中,我可以盡量找理由排除最不可能的答案,最終逼出唯一剩下的那個也很奇怪的答案,常常也就是MNIST設定的標準答案了!辨識率就繼續提高了!每個案例總有一個答案的嘛! 這就是所謂的福爾摩斯定律了: When you have eliminated the impossibles, whatever remains, however improbable, must be the truth! 事實上我的整個辨識邏輯架構就是建立在這個假設基礎上的!我確實建立了很多可以「正向」辨識目標是哪個數字的特徵,譬如數字179都有較長的下方直線之類的!我想傳統上的Rule based研究者都是這樣開始的!有了很多正向特徵之後就是把它們變成可以量化的加權參數!最終加權分數最高的數字就是答案了!其實CNN與DL的辨識架構也差不多這樣做的! 但是手寫字的變異量實在太大,要靠這些人為設計的特徵確認是甚麼字?能做到的極限大概就是七八成而已了!CNN與DL可以做到更高辨識率其實就是千百個臭皮匠(電腦自定特徵)湊成的一個諸葛亮!它們是用電腦的無限算力建立非常多特徵來做更詳細的比較,然後根據標準答案來自我調整特徵加權數來逼近最高辨識率的! 但我這個辨識核心的設計一開始就不是這麼想的!我小時候就很喜歡看福爾摩斯的小說嘛!他是我的偶像!我的整個辨識架構就是一個殘酷的淘汰賽而不是選美比賽!任何一個答案會出線都不是因為它「最像」哪個數字?而是「其他數字的可能性都被逐步淘汰殆盡」了!這才是我短時間之內不依賴CNN與DL就可以迅速達到極高辨識率的主要原因!我真的顛覆了影像辨識的概念!可以說大家都在做正加權,我是用負加權的! 上面這些5的案例就是這樣來的!直接看真的沒有一個像是5!我自己的常識與直覺也不會判斷是5,但是當我的軟體逐一考慮所有數字的可能性時,好像大風吹遊戲吧?最後倖存搶到最後一張椅子的人就是贏家了!即使他看起來根本不像個贏家都沒關係了!手寫數字辨識的遊戲規則就是盡量「猜」一個數字嘛!
|
|
| ( 心情隨筆|工作職場 ) |