字體:小 中 大 |
|
|
|
| 2026/10/02 10:51:36瀏覽74|回應0|推薦0 | |
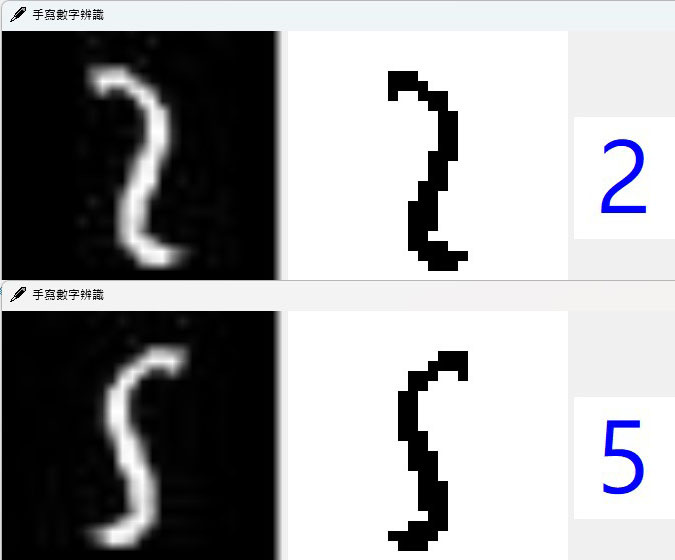
手寫數字辨識已經挺進到MNIST標準的96.8%了!非常辛苦,每天可能只挺進個零點一或二趴!但是也非常有趣!都是在我的充分理解掌握之中進化!不像機器學習操作者那麼因為無知而焦慮!深怕訓練參數一下錯系統就會大崩盤!還不知道原因? 兩個月前原本只是粗略設計的特徵屬性現在逐步進化,越來越精確,也越來越有深度!用來分辨不同字元的能力也越來越穩定精確!感覺好像是從最簡單的約法三章,逐步將一套法律增修演變成一部六法全書了! 如上案例其實是我故意用PS軟體將某字左右翻轉再辨識的結果,狹長的2就變成5了!一個月前我的辨識核心當然都會把它們當作是1的!但是隨著特徵辨識的架構越來越精緻完備,感覺就是我的軟體越來越聰明,也就是越來越AI了!一般人應該也會說上面的兩個字是2與5!說是1的人就顯得有點笨了! 正如深度學習說的:要做好複雜的辨識,必須設定較多的隱藏層(Hidden layers)!對應到我的Rule based辨識就是辨識流程了!只靠單一步驟的決策當然是太粗糙錯誤率很高的!所謂的機器學習ML與深度學習DL最大的差異也就是這種模型複雜度的差別!我做的事情在架構概念上也跟深度學習很類似!但是差別是我不依賴電腦自己大量計算嘗試錯誤摸索出方向,比較像是最高度介入的監督式學習!所以過程中使用深度學習的人只是在看戲,我則是掌握所有狀況的導演! 如上的案例當然會先看它們的粗細,但是接下來也會檢視它們的彎曲狀態,就會發現有夠明顯的曲度,再分析轉折點的位置,就可以分辨是2或5了!很好玩吧?完全自己手動建立出一套可用的影像辨識規則是天大的樂趣!我寫博士論文時就做過一次!後來做車牌辨識還多少參考了很多論文,但是手寫辨識又是完全跳脫前人研究的!能如此創新還證實有用?真的太太太好玩了! |
|
| ( 心情隨筆|工作職場 ) |