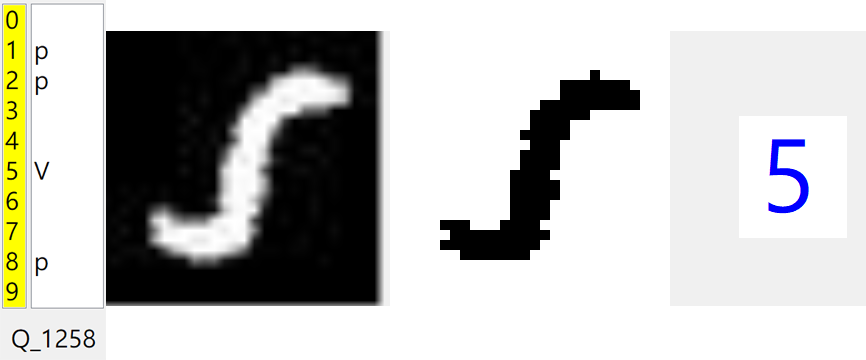字體:小 中 大 |
|
|
|
| 2026/09/30 09:59:56瀏覽100|回應0|推薦0 | |
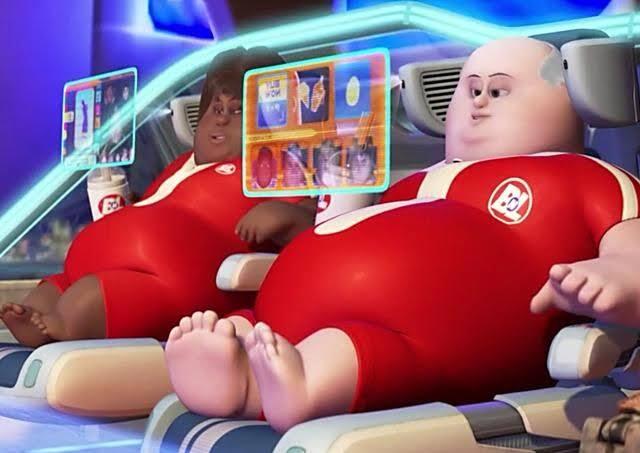
我現在正在做的手寫數字辨識邏輯,一個有趣之處是我把負面表列的精神發揮到了極致!正如福爾摩斯的名言「當你把一切不可能的情況都排除之後,那剩下的,不管多麼離奇,也必然是事實。」手寫字是沒有標準字型的!要辨識他們想用正面表列,就是符合某些特徵時就一定「是」甚麼字?的概念只會出現一大堆無法解決的衝突矛盾! 但如果以負面表列,就是找碴的概念,嘗試找出某目標一定「不是」甚麼字的原因?反而比較簡單!如上案例就是一個非常有趣的個案!我的程式初步判斷它可能是1258四個數字之一!但是以1來說它彎曲度太大了!沒有人寫1字會彎成這樣的!以2來說呢?上方的彎曲方向相反了!以8來說呢?它沒有上下寬中間窄的特徵。只有5你找不到否定它的明顯原因!所以答案就是5了! 所以這個研究雖然一開始會覺得千頭萬緒好像沒有明確可依賴的辨識準則?其實就好像一個從來沒看過數字的小貝比,對他們來說感覺應該就像我們看到陌生的阿拉伯文!但是只要假以時日累積經驗,在小小的腦袋瓜子中逐步建立辨識用的特徵準則,小朋友終究都可以看懂爸媽手寫的數字了! 其實我的影像辨識理念就是想挖出一般人腦袋中的辨識邏輯!只要能理解掌握人腦的視覺智慧,正確將他們翻譯成電腦程式,就一定是最準確也最高效率的軟體了!現在大家都說CNN等技術就是模擬人腦的思考模式?但是我覺得他們的想法太過簡單,也過度黏著於矩陣計算的概念了! 我覺得一般人在複雜背景中找到目標的方式應該不像CNN那麼繁瑣要使用矩陣做地毯式的掃描!應該比較像OCR的直接掌握對比度高的區塊,再進一步將區塊的輪廓勾勒出來!這樣計算的量是CNN的數十分之一!也就是速度會快數十倍!需要的電腦規格也就很低!執行時的耗電量當然也很低! 所以現在會流行使用CNN與DL應該不是人腦真的是那麼運作的!而是走那條矩陣之路會比較適合利用電腦的功能幫助我們累積經驗,就是機器學習派說的學習或訓練了!有點像財大氣粗的土豪!自己沒學問也不想傷腦筋親力親為,就請一大堆奴隸幫忙做所有的事了! 如果你擁有無限的資源,這樣做也無可厚非!但是事實上極少人可以耗費那麼大的成本用低階的智慧工具完成複雜的模型!即使真的千百個臭皮匠湊出了幾個諸葛亮,模型內部的執行效率也是非常低落的!所以他們才需要不斷的精進YOLO,也不斷地想動用更多電腦週邊設備來消化計算量!其實只要演算法改變一下就不必這麼麻煩了!我的軟體就完全不需要GPU的! 我想另一個好大好大的無形損失是:如果大家都把「思考與設計」的工作完全外包給電腦!就是做甚麼事都只靠AI工具?那麼我們距離電影瓦力中的公理號居民那種身心退化癡肥無用的狀態就不遠了!那樣像是活死人一般不必動腦的「工作」與娛樂方式是你希望的美好未來嗎?他們都不必自己動腦寫程式的!有AI代勞嘛!
|
|
| ( 心情隨筆|工作職場 ) |