字體:小 中 大 |
|
|
|
| 2026/09/28 04:28:42瀏覽62|回應0|推薦0 | |
作研究是我的工作也是我的娛樂!能夠用最聰明有效對症下藥的方式設計出各種類型的影像辨識方法是我目前生活中最大的樂趣!擺脫了在學界必須把做研究變成被很多框架桎梏下的制式工作,我現在可以天馬行空玩得很開,不必考慮論文或研究計畫評審教授的觀點想法,直指最有意義的目標!就是做出真的可以用的好軟體! 我最近兩個月做的手寫數字辨識就非常好玩!如果你上網搜尋幾乎完全找不到「非」CNN與DL的研究方式!我是讀過不少早期論文才知道在此AI風潮之前真的有很多基於OCR與細線化或向量化手寫筆畫來辨識是甚麼字的研究!也就是說網路資訊呈現的是這個世界已經完全放棄用Rule based的方式做這種影像辨識了!但我就是想嘗試「不用」CNN與DL的解決方案! 如前文所述,我是建立了很多可以明確定義的特徵,如短直線或封閉區間或轉折點等等,每個這類特徵就會有位置、寬高、粗細與傾角等很多附屬的屬性!利用它們來描述與分辨目標案例「是」甚麼字?或「不是」甚麼字?搜尋建立這些特徵的方式不像CNN必須做很多矩陣掃描,所以速度是不必用GPU就很快的! 所謂的CNN也是必須先收集影像特徵,再讓DL去深度學習的!但是他們不想自己認真設計出對辨識特定目標有意義的特徵,只是用最簡單的直線、斜線或顏色區塊等極簡特徵為基礎,所以要讓DL學會組織這些基礎資訊去辨識目標就會是非常漫長的路了!所以「學習」或「訓練」就需要非常龐大的計算量!也不得不動用超規格的超級電腦才行了! 我不打算也沒資本花很多錢做這些研究,所以就盡力動自己的腦筋想出不必依賴龐大計算量的方法!建立對辨識特定目標有意義的特徵就是第一步了!其實上面說的以前不用CNN的前輩已經嘗試過很多方法了!但是顯然效果都不夠好,所以才會變成被CNN與DL完全攻佔!我不想用CNN與DL當然就盡量不要重蹈前人失敗的覆轍,要創新一點了! 建立特徵只是第一步,如何使用這些特徵的學問當然更大!現在的CNN與DL學派當然是不肯自己動腦解題,直接交給電腦去自學的!也就是辨識0-9的十個字就是一場十人同時進場比賽的大亂鬥!他們只是給電腦足夠複雜的模型架構,稱之為很多的隱藏層!每一層內部更有非常多的參數,讓電腦自己經過錯誤反饋去調整到最佳狀態。
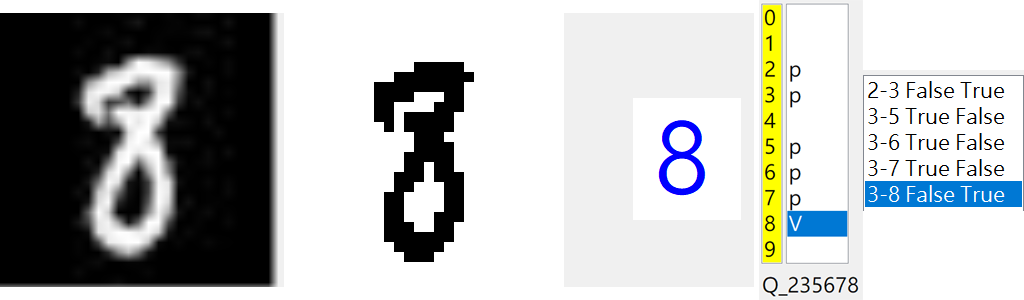
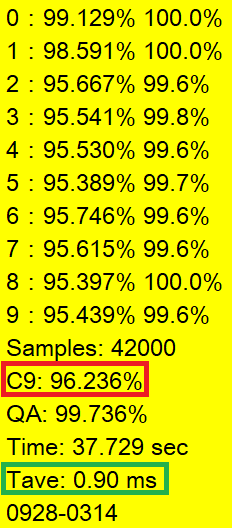
我則是把DL的大亂鬥拆解成一對一的淘汰賽了!如上圖中的案例,這個字在我的初步篩選中被認為有可能是235678等幾個字!接下來我就讓它們捉對廝殺!譬如第一場賽事是它比較像2或比較像3?結果是3勝出!依序比下去最終就是8獲得冠軍了!這種「賽制」就讓場面變得簡單好控制多了!整體計算量當然也會精簡很多了! 有效嗎?目前表現不錯的!以MNIST的標準答案計算辨識率已達96.236%!每個字辨識的平均時間也只需0.9「毫秒」!所以這絕對會是一個可以直接在一般規格的電腦上輕鬆執行的高辨識率軟體!不會像CNN與DL訓練出來的模型那麼龐大笨重!常常大到必須使用雲端的超級電腦?那就不是我可以做的生意了!
|
|
| ( 心情隨筆|工作職場 ) |