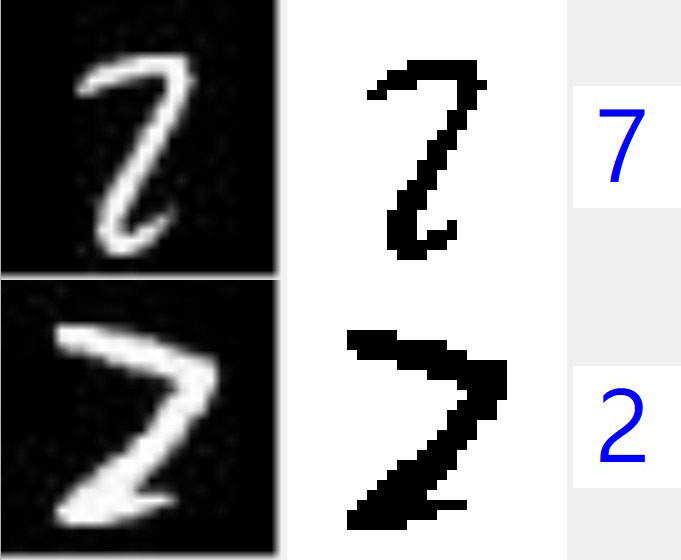字體:小 中 大 |
|
|
|
| 2026/10/13 15:59:35瀏覽95|回應0|推薦2 | |
現在我的Rule based手寫數字辨識已經挺進到以MNIST字集為標準的97.5%辨識率了!一如我的預期,現在已經進入有如Twilight zone的模糊地帶了!我每次更動任何一個辨識準則都會有得有失,某字的辨識率高了就一定有某字的辨識率變低!損益平衡之後總辨識率變高的機會越來越少了!當然我還是會再努力幾天,看看有沒有遺漏掉能讓辨識更合理的細則! 如我之前一再強調的!我的目標不是跟甚麼XNN系統比拚99.X%的辨識率高下!我原本預估就是會停在目前這個辨識率附近!預計超過98%就沒有實質意義了!如果你聽不太懂我就舉個例子給你看看!如上的兩個案例就是很好的證明,相信任何人都很難斷定它們是2或7吧? 但是要定義出某辨識方法的辨識率就必須有標準答案,所以MNIST必須給一個標準答案!弔詭的是決定標準答案的方式並不科學!只是字集提供者的主觀認定!他們說上面的是2下面的是7!原則上我會盡力配合,找到適當的準則分辨出如MNIST提供的答案,但那個尾巴要到多大才算是2而不是7呢?怎麼調整都不會達到MNIST完美的!因為它們實質上就是有模糊地帶,MNIST本身的答案就會自相矛盾的! 但是以機器學習的語彙來說,這些沒有科學根據,只是資料提供者主觀決定的答案就是所謂的Groud Truth了!字面上的意思就是不可爭議的事實!想得到好成績的人就只能無所不用其極地做出MNIST要的標準答案!其中大約97-98%是一般人投票表決都還會有共識沒有太大爭議的,也就算了!剩下的2-3%就是我說的陰陽魔界(Twilight zone)了! 問題的關鍵就是我的Rule based系統應該如何面對這有爭議的2-3%案例呢?如果我就是橫柴入灶,非得到跟MNIST提供的答案一樣的辨識結果,我就會被迫建立一些不合乎一般人常識的辨識準則!譬如上面的例子,上方字尾轉角圓滑的MNIST說是2,下方轉角較尖銳的MNIST說是7,我只要建立一個這種轉角圓滑度的準則我的辨識率就又提高一點了! 但是我當然不會這麼作的!因為這並不是可以合理通用的準則!只是配合資料硬掰的湊答案原則,或許適用於訓練用的資料,但是拿到外面用就沒有合理意義,甚至會誤導辨識了!這就是機器學習派語彙中說的Overfitting(過度擬合)了!我堅持不做這種傻事的代價就是我永遠無法突破98以上的高分!但是我的軟體拿到訓練資料之外使用時不會有不合理的奇怪辨識邏輯!
但是顯然那些CNN與DL的盲目競爭者是不管這些事實的!所以上面的報告才會強調CNN可以達到99.85%之類的!一般人其實不太懂,以為那是表示該方法很厲害的好事?其實是過猶不及!訓練成績只要超過98%就鐵定是Overfitting了!不但做成軟體時不會更合理準確,反而會因為屈從那些其實不合理的標準答案而讓辨識能力實質上變差了! 所以你還要盲目相信甚麼版本的XNN或DL辨識率最高就是好貨嗎?事實就不是這樣的!上面說的「真實世界或開放測試」的成績才是真正使用者的實際感受!那才是我做此研究追求的目標!要追求這個目的就是我的軟體辨識原則邏輯必須與一般人識別數字的邏輯越接近越好!過度硬拚MNIST的高分是會有反效果的!系統會變得太龐大,多出的部分都是沒用還會搗亂的overfitting細則。 |
|
| ( 心情隨筆|工作職場 ) |